AI PC时代:大模型本地化,别让 SSD 拖了算力后腿!
AI PC的下半场,算力之外还有存储这道关
过去两年,AI PC几乎成了整个PC行业最炙手可热的概念。从芯片厂商到整机品牌,从操作系统到应用生态,所有人都在讲述同一个故事:AI正在从云端走向本地。最初,这个趋势更多停留在概念层面——NPU算力、TOPS数字、端侧大模型,听起来都很美好,但普通用户的感知并不强烈。然而现在情况发生了实质性的变化。以DeepSeek、Qwen、MiniMax为代表的开源大模型生态彻底爆发,各类经过蒸馏和量化压缩的中小参数模型,已经可以在家用PC上流畅运行。本地AI助手、离线知识库问答、本地语音转写、AI驱动的代码补全、会议纪要自动整理,这些曾经必须依赖云端API的功能,如今在一台配置合理的个人电脑上就能完成,既不用支付订阅费用,也不必担心隐私数据上传云端的安全问题。
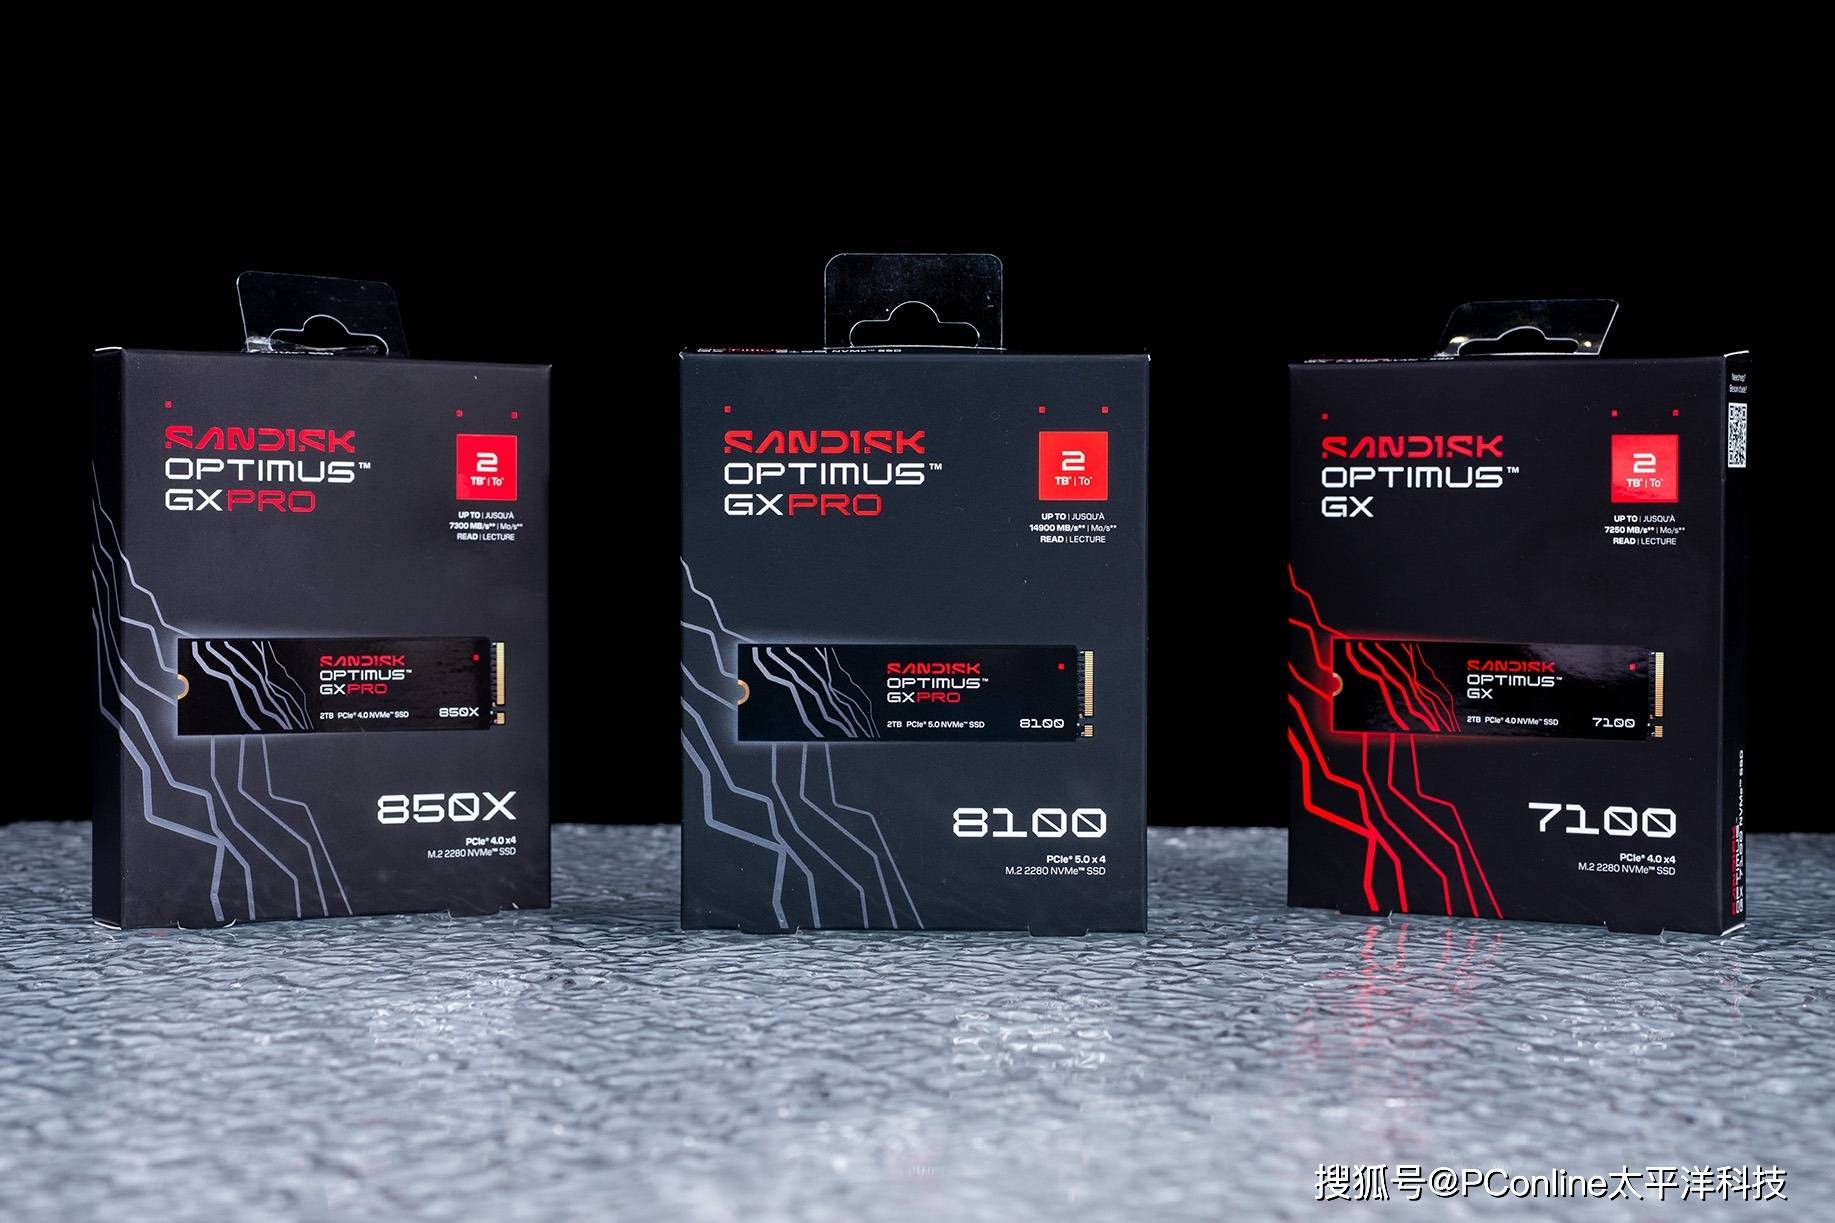
闪迪Optimus GX PRO 8100 2TB M.2 SSD京东商城¥4999
这股潮流背后,是用户对AI态度的微妙转变。大家不再满足于"联网问一句、云端答一句"的浅层体验,而是希望AI真正成为自己电脑里一个随叫随到、完全私有、响应即时的工具。高校学生在宿舍用本地大模型整理论文文献和课堂录音,职场人把会议录音丢给本地模型生成纪要,考研党用本地知识库搭建自己的复习问答系统——这些场景的共同点是:模型要常驻本地,数据要在本地流转,整个工作流完全在自己的SSD上跑完。
也正是在这个过程中,一个过去被严重低估的硬件环节开始浮出水面:存储。当我们讨论AI PC时,注意力往往集中在CPU、GPU和NPU的算力指标上,却很少有人认真思考一个问题——几十GB的模型文件要从哪里读取?每秒数GB的推理数据要在哪里流转?动辄数小时的连续负载要由谁来稳定承载?答案都是内置固态硬盘。
本地AI工作负载对存储提出的要求,与游戏加载、日常办公截然不同:它需要的是强悍的随机读写性能来应对模型权重的碎片化读取,需要足够大的容量来容纳不断膨胀的模型库和数据集,需要出色的能效与散热控制来保证长时间推理过程中的性能一致性,还需要足够高的耐久度来承受频繁的模型加载、数据交换与缓存写入。可以说,在本地AI时代,SSD正在从一个"仓库"变成一条"高速公路",它的规格直接决定了AI体验的流畅度。
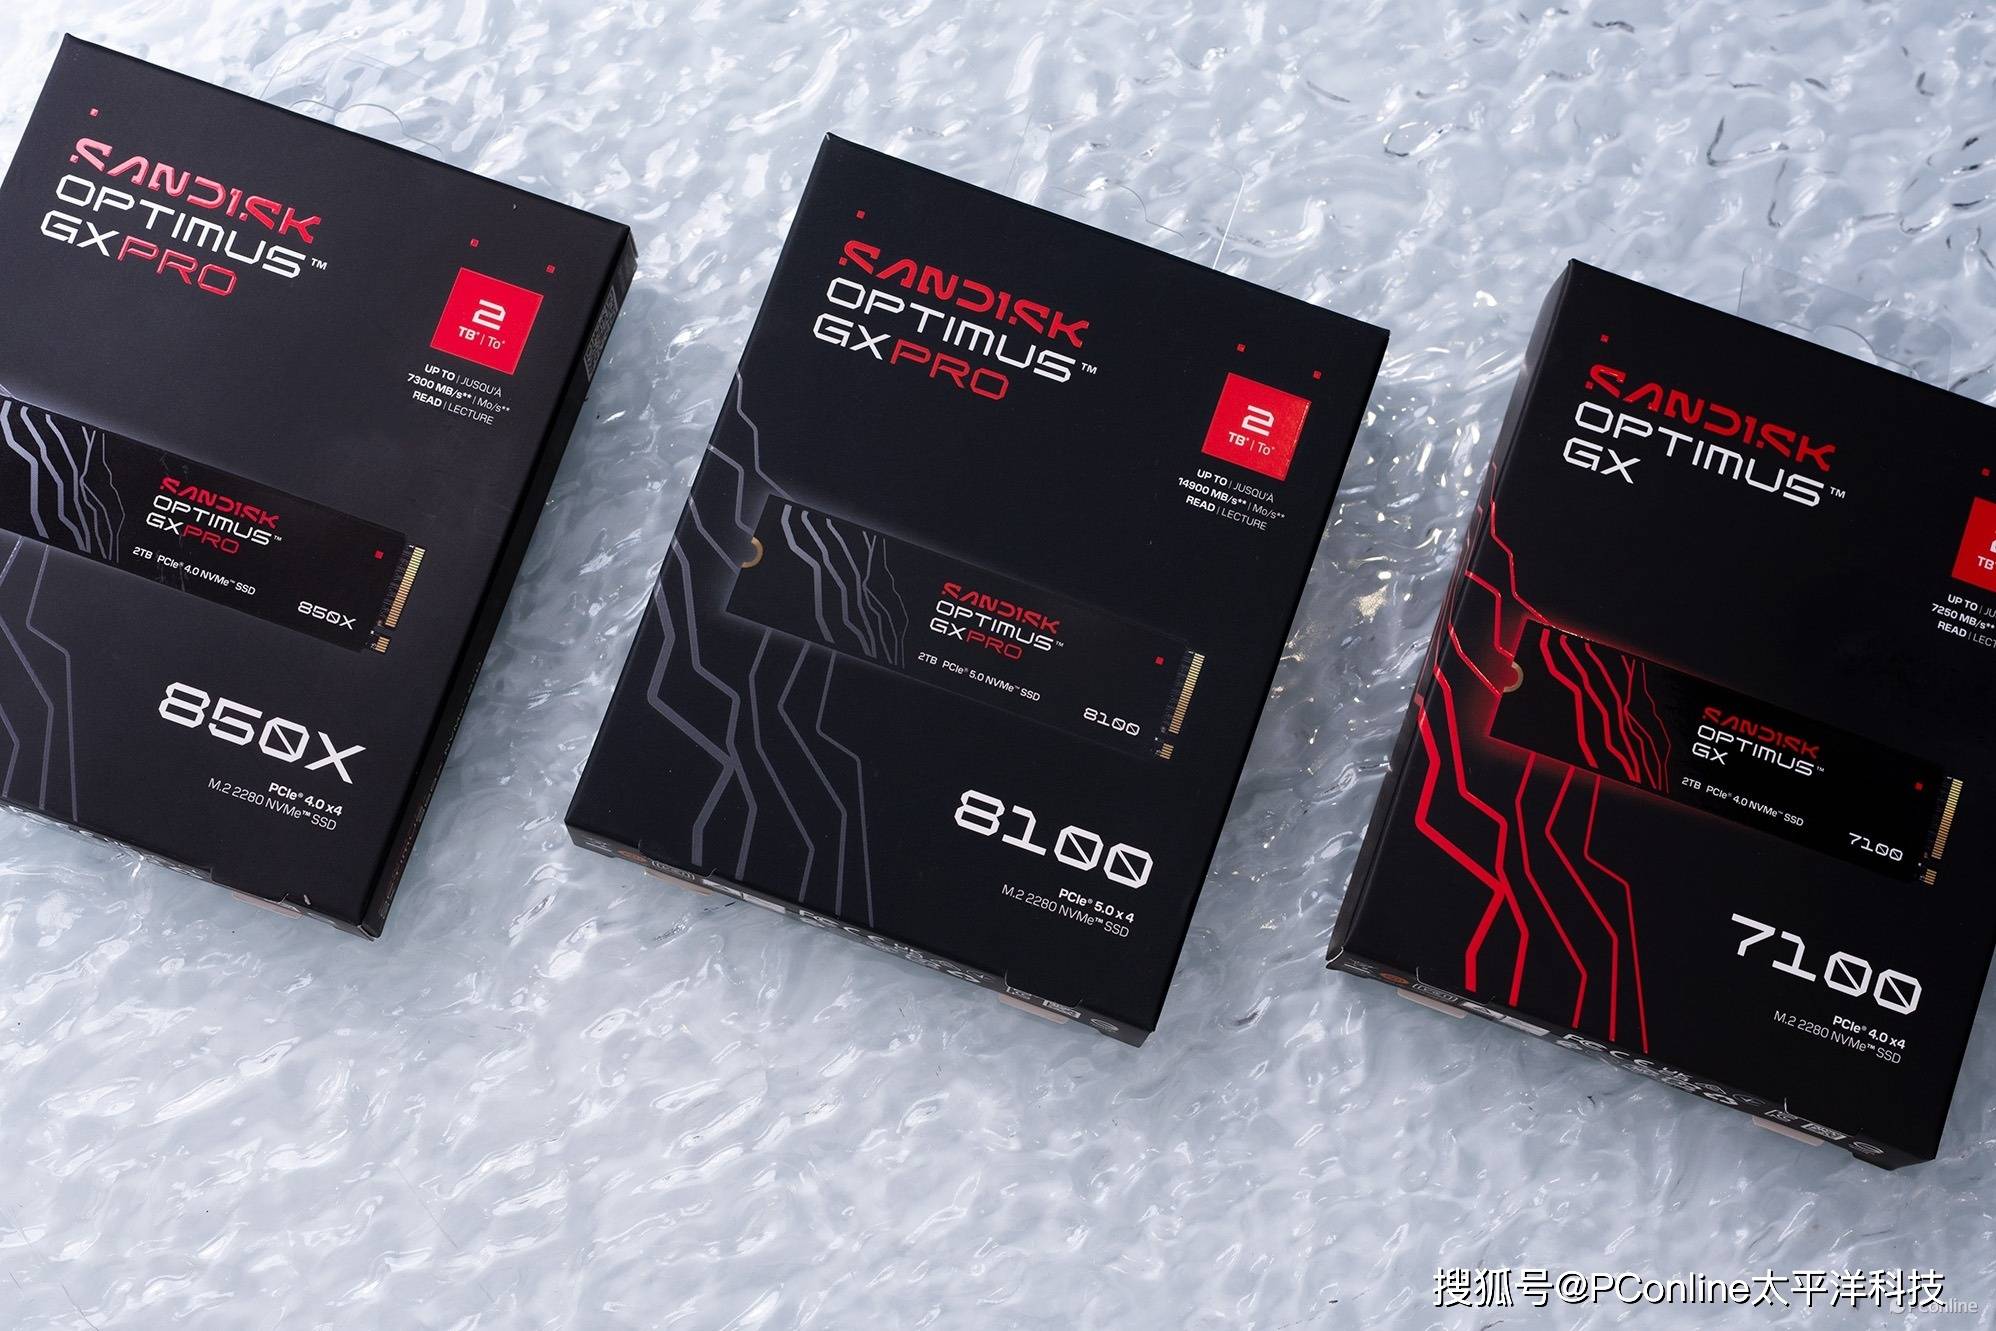
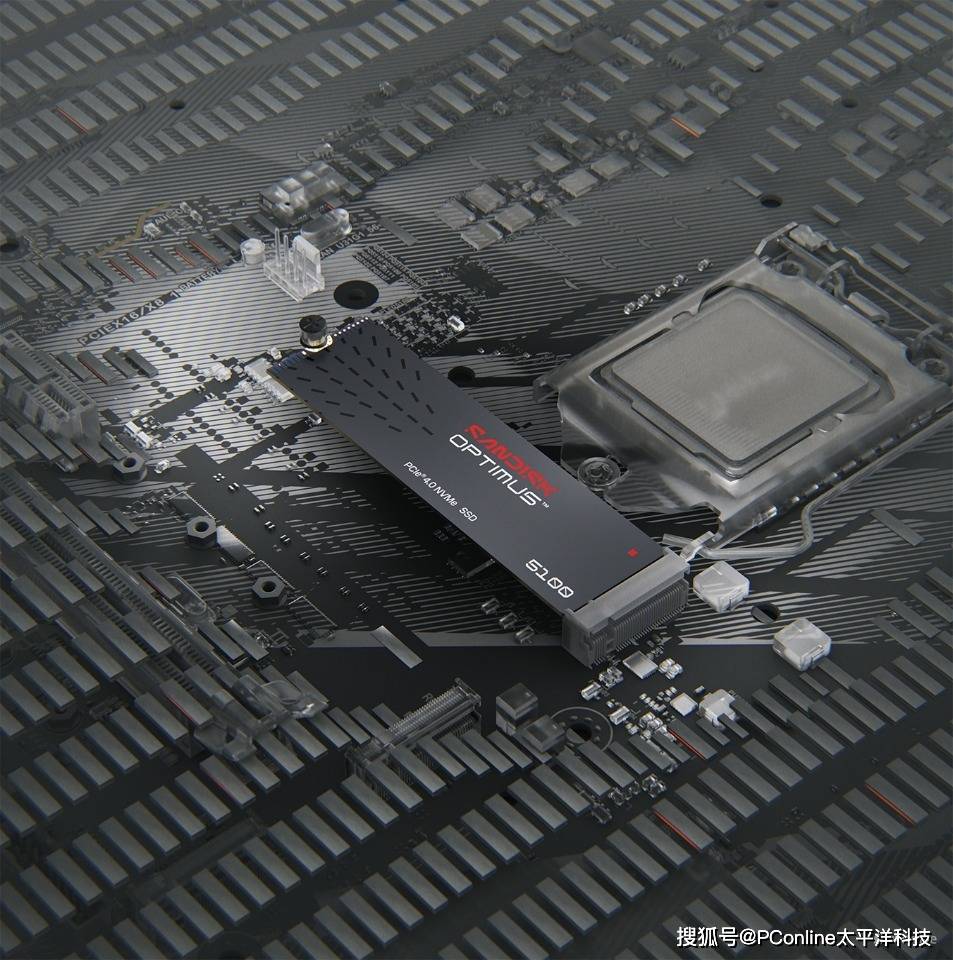
本次我们将做一次贴近真实使用场景的实测:围绕当下热门的本地AI应用场景,检验存储设备在AI工作负载下的真实表现。本次测试的重点产品,是闪迪旗下SANDISK Optimus闪迪奥丁马仕系列的旗舰型号——闪迪奥丁马仕 GX PRO 8100 NVMe SSD。
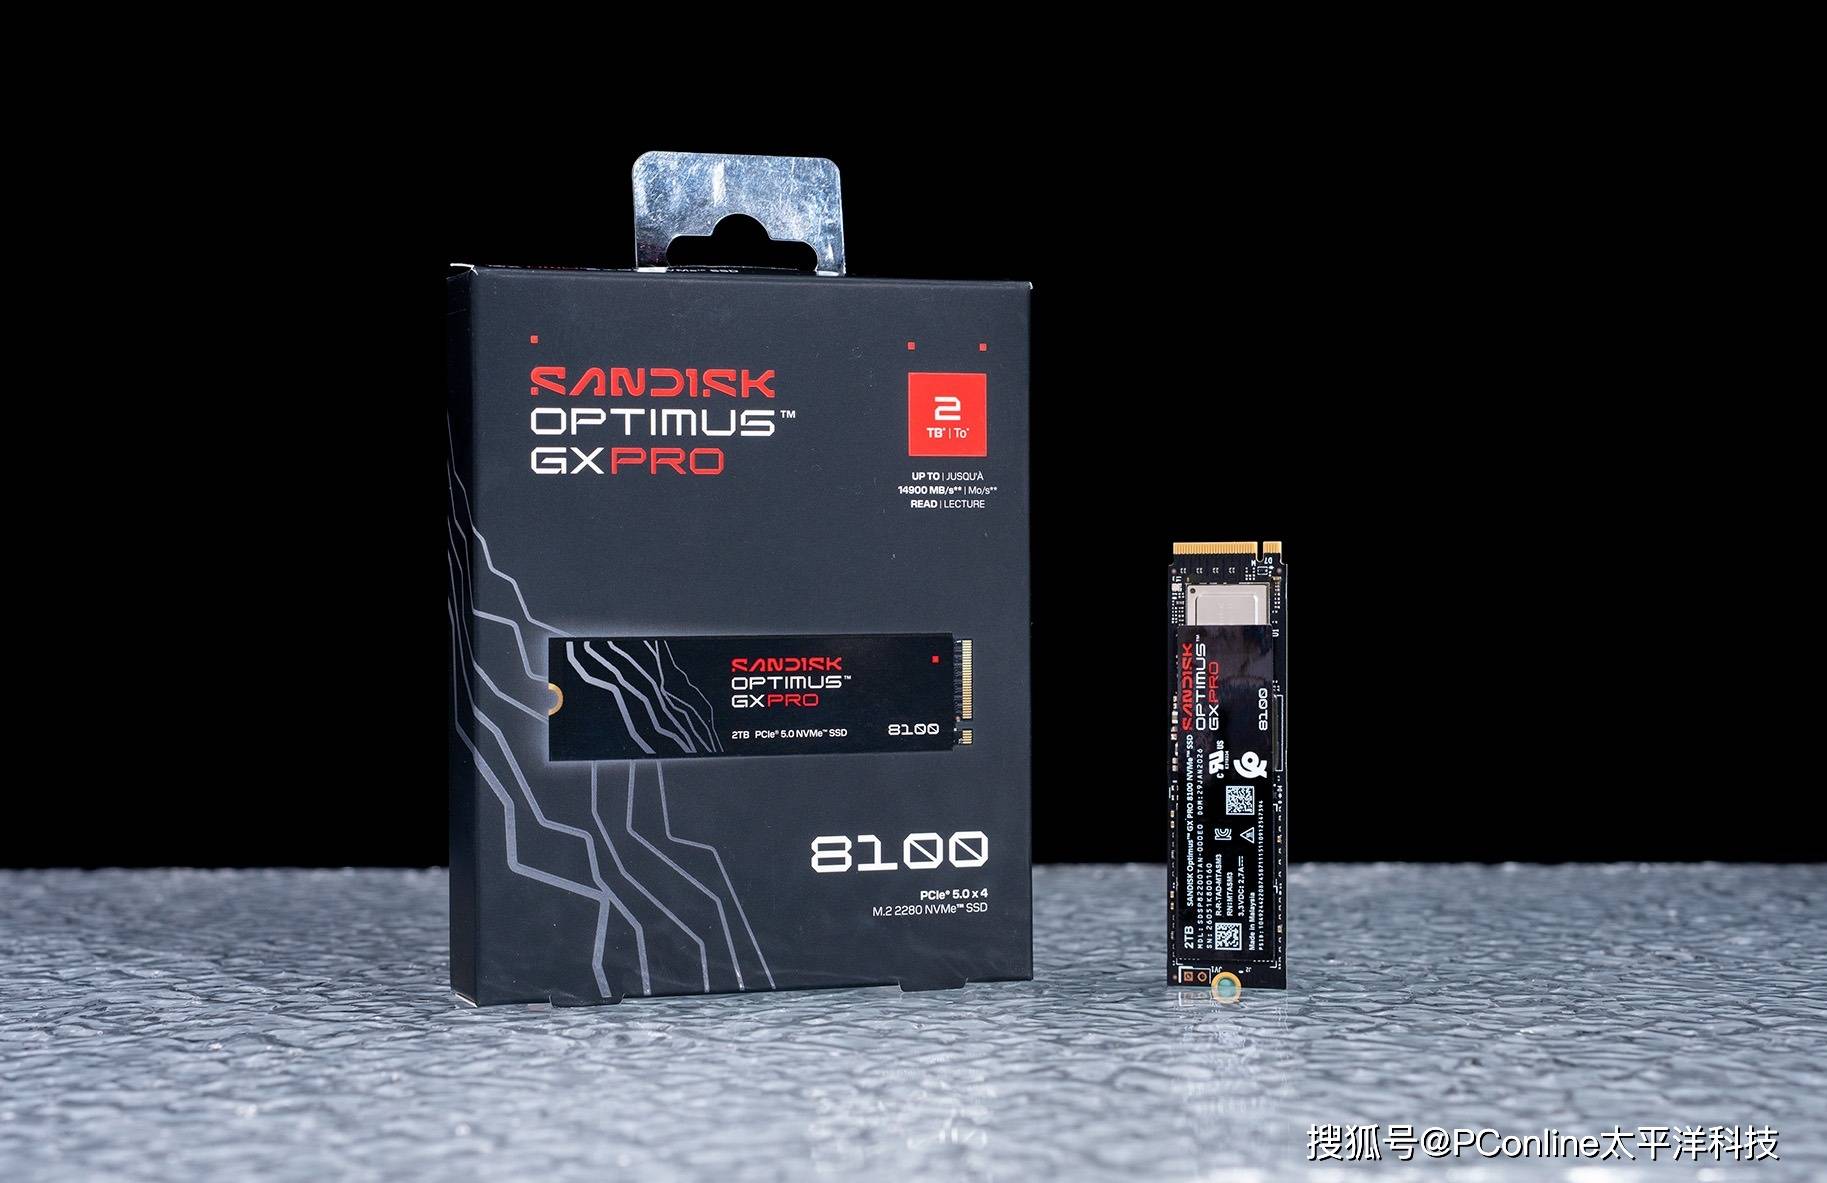
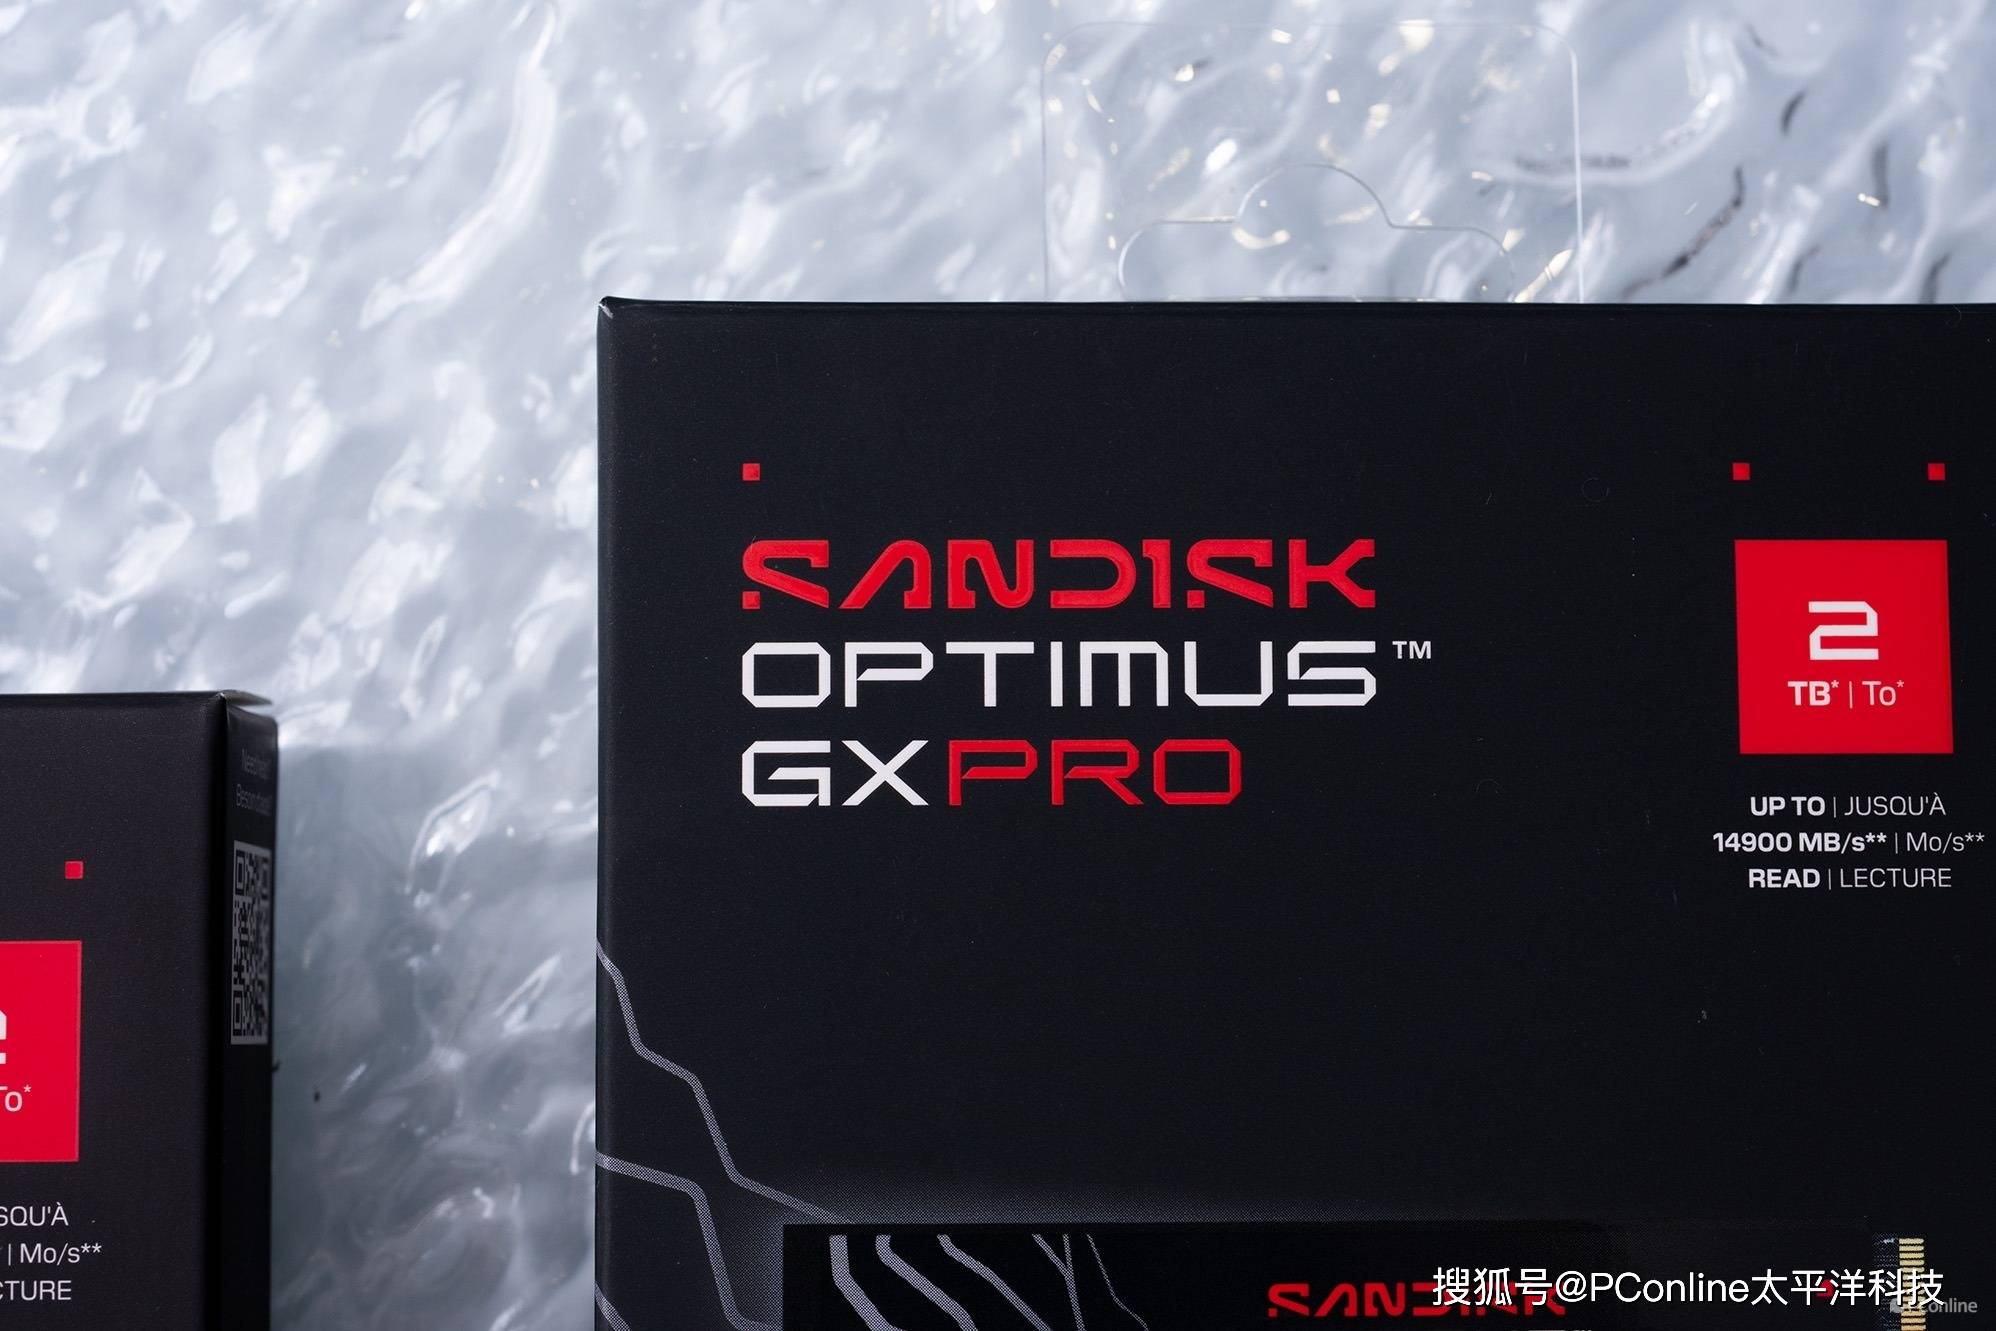
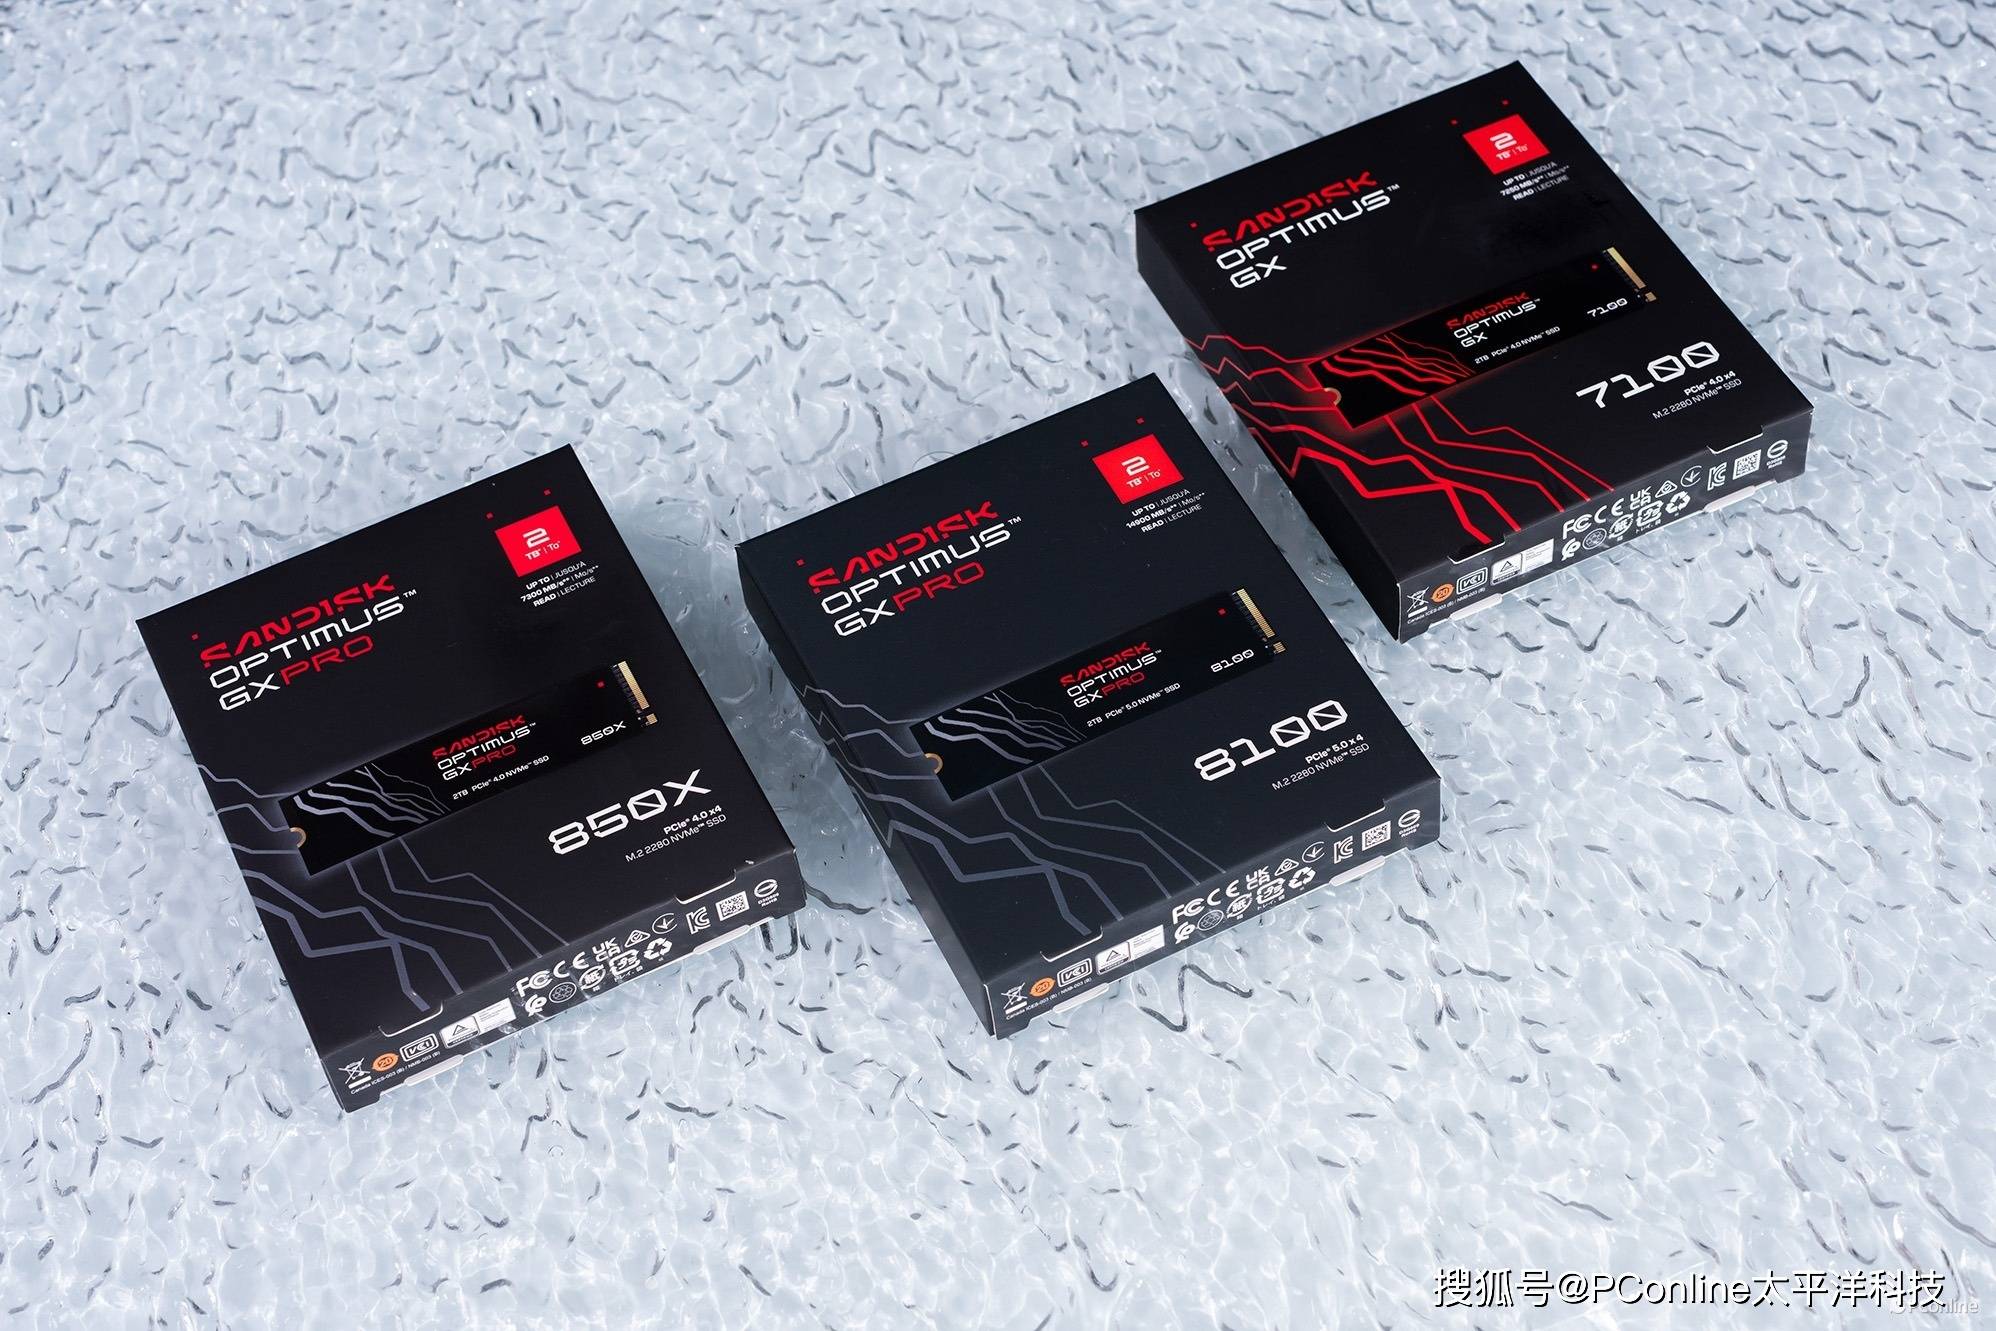
在正式开始测试之前,有必要先介绍一下这个系列。SANDISK Optimus闪迪奥丁马仕系列是闪迪专为游戏玩家和专业人士打造的客户端SSD产品线的焕新名称,旗下包含SANDISK Optimus系列、SANDISK Optimus GX系列以及SANDISK Optimus GX PRO系列三大产品线。
本地AI工作,到底需要怎样的SSD?
测试前我们先把本地AI场景对存储的需求拆解清楚。很多人对AI应用的存储压力缺乏直观认知,以为模型下载一次、加载一次就结束了,实则不然。
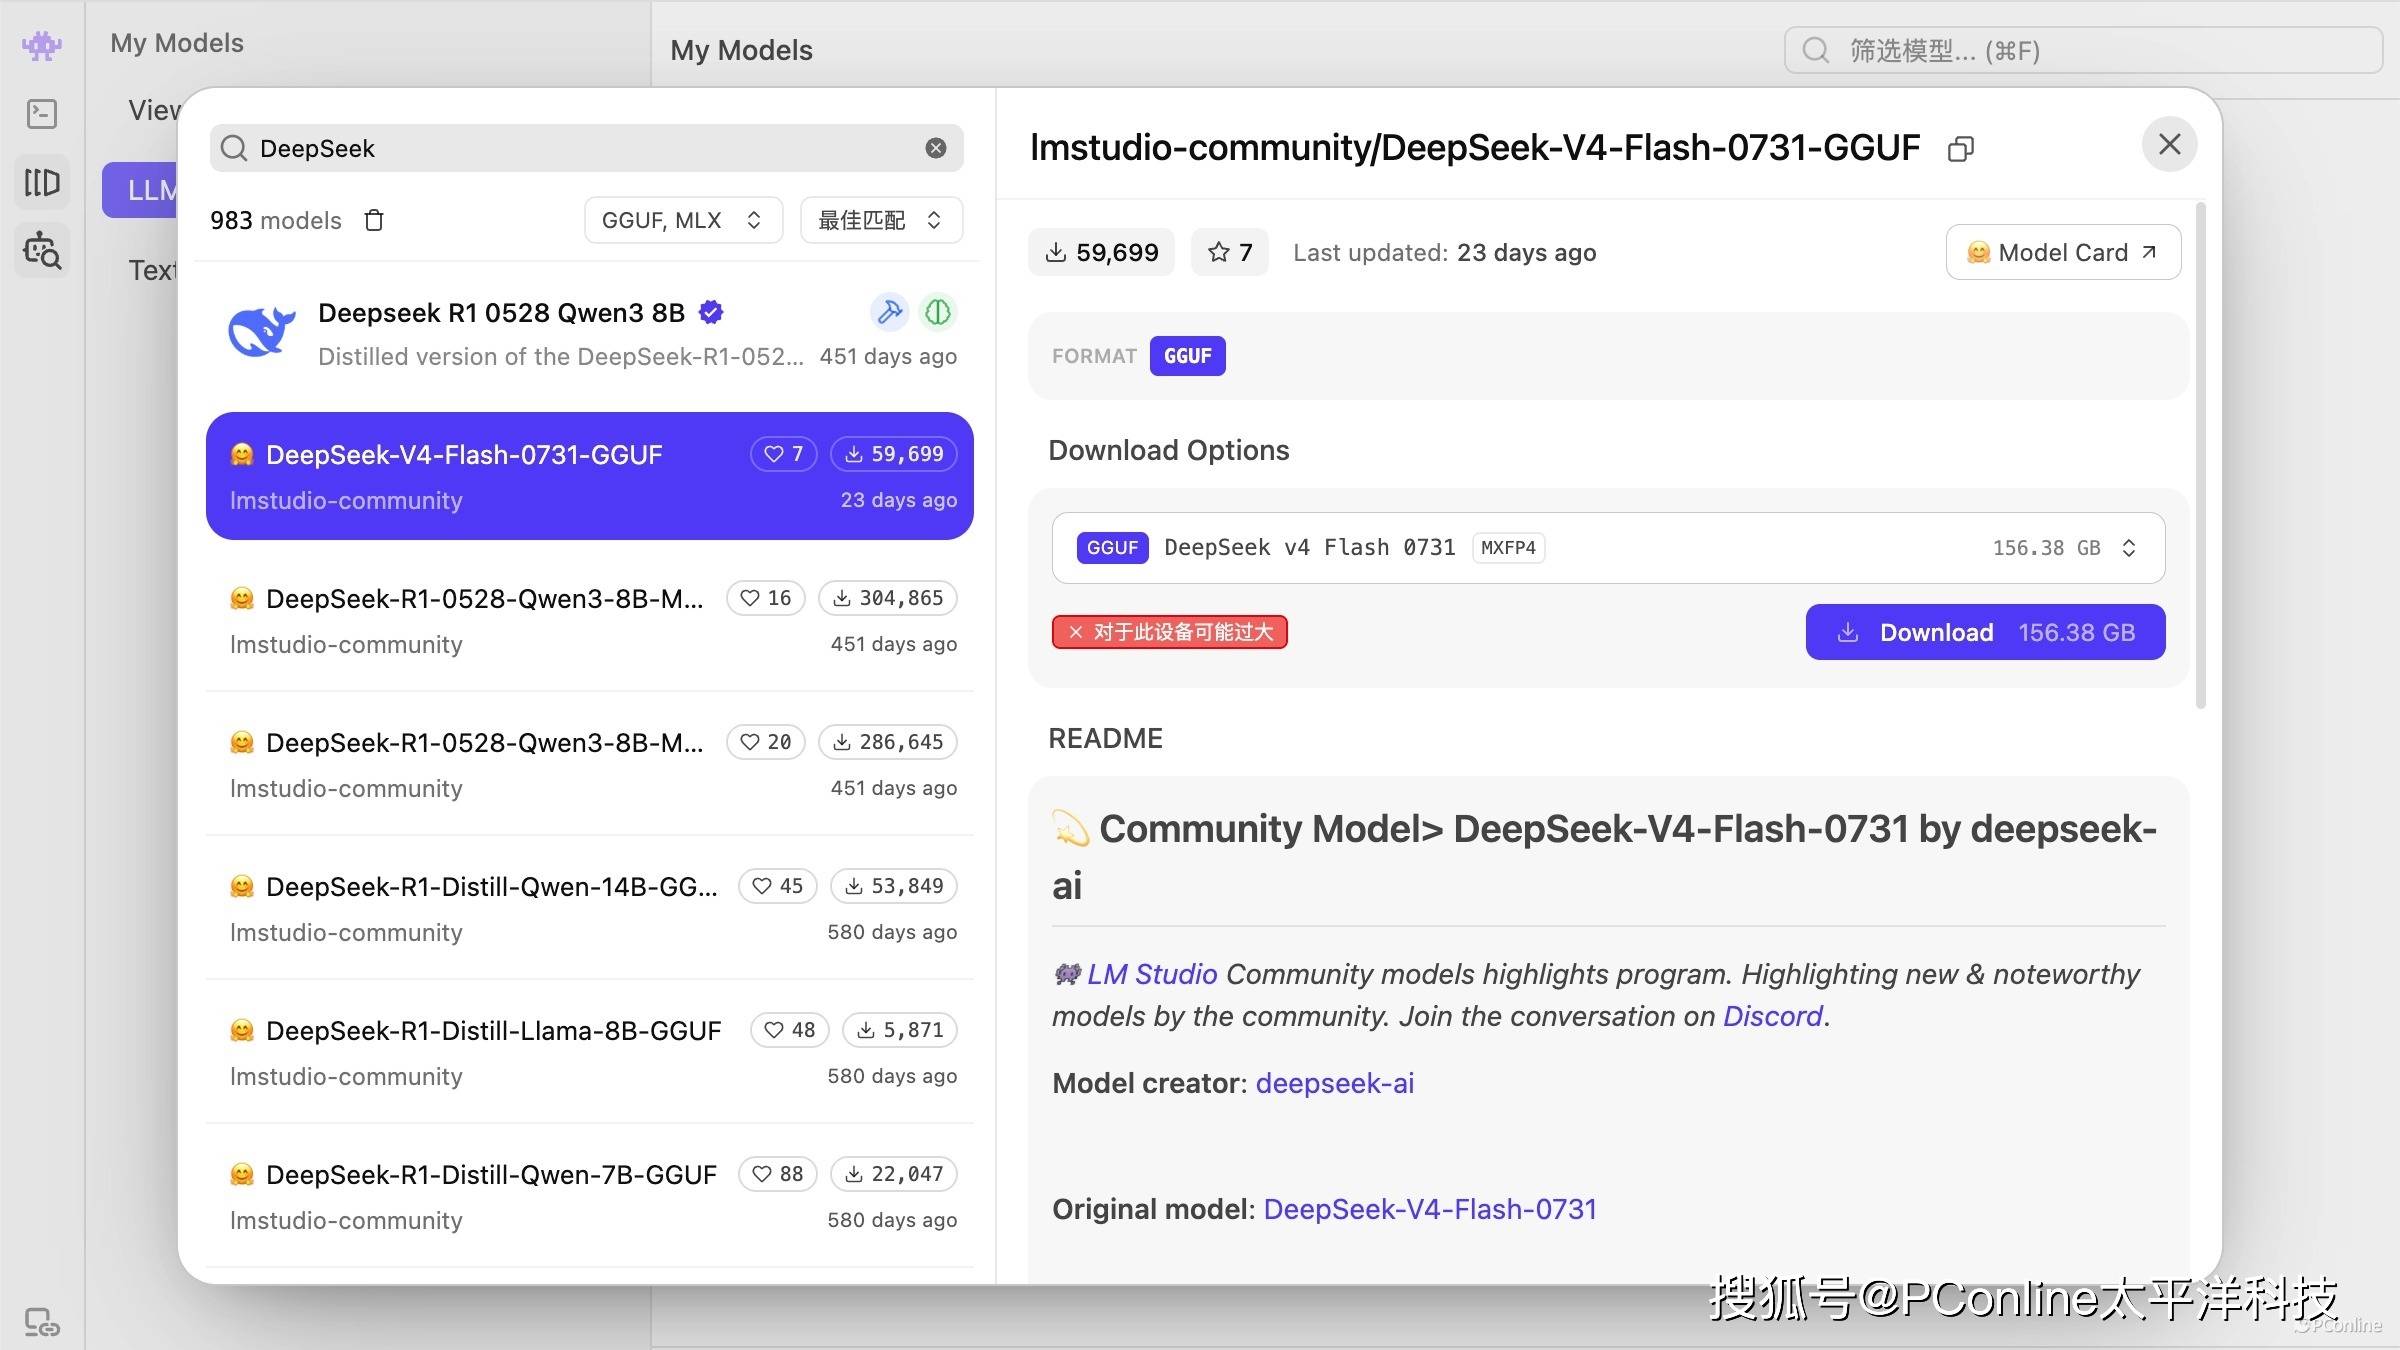
首先是容量层面的压力。本地AI用户,SSD里往往不止一个模型。以当前主流的量化模型为例,一个7B至8B参数级别的模型在4bit量化后约占4GB至5GB空间,14B级别约8GB至9GB,32B级别约18GB至20GB,而70B级别即便压缩到4bit量化也需要40GB上下。如果你还想体验未经量化的原始精度版本,体积还要翻倍甚至数倍。再加上语音模型的模型文件、本地知识库的向量索引、源源不断积累的对话数据与文档资料,存储占用突破200GB只是时间问题,达到500GB以上也并不稀奇。更关键的是,模型生态迭代极快,新架构、新版本层出不穷,用户普遍会同时保留多个版本的模型以便对比和切换,存储需求是持续增长的。
其次是性能层面的压力。AI模型加载本质上是一次超大文件的高强度读取过程,加载速度直接取决于SSD的顺序读取能力——SSD越快,从双击启动到开口对话的等待时间就越短。而在推理过程中,情况则更加复杂:当内存不足以容纳整个模型时,系统需要将部分模型层换出到SSD,此时决定体验的是SSD的随机读写性能,成千上万个小块的随机读取密集发生,SSD的IOPS水平直接影响回答生成的流畅度。此外,向量数据库的检索、知识库文档的索引更新、长上下文处理中的缓存交换,都是典型的随机读写密集型负载。这也就解释了为什么闪迪奥丁马仕 GX PRO 8100在产品定义上如此强调随机性能——AI模型的高效运行,恰恰依赖出色的随机读写表现。
最后是稳定性与耐久层面的压力。与游戏加载"读一把就歇"的间歇性负载不同,本地AI推理一旦开始,往往是连续数十分钟乃至数小时的持续工作。批量文档处理、长时间语音转写、大规模知识库索引构建,这些任务会让SSD长时间处于高负载状态。如果SSD的功耗控制不佳、散热能力不足,温度升高后触发降速,用户会明显感觉到AI响应越用越慢。而频繁的模型加载、缓存写入、数据交换,也在持续消耗SSD的写入寿命,写入密集型的工作负载对SSD的TBW指标提出了实实在在的要求。
综上所述,一块适合本地AI场景的SSD,必须同时满足四个条件:足够快的顺序读取速度、足够强的随机读写性能、足够大的容量、足够优秀的能效与耐久。
闪迪奥丁马仕 GX PRO 8100 NVMe SSD规格介绍
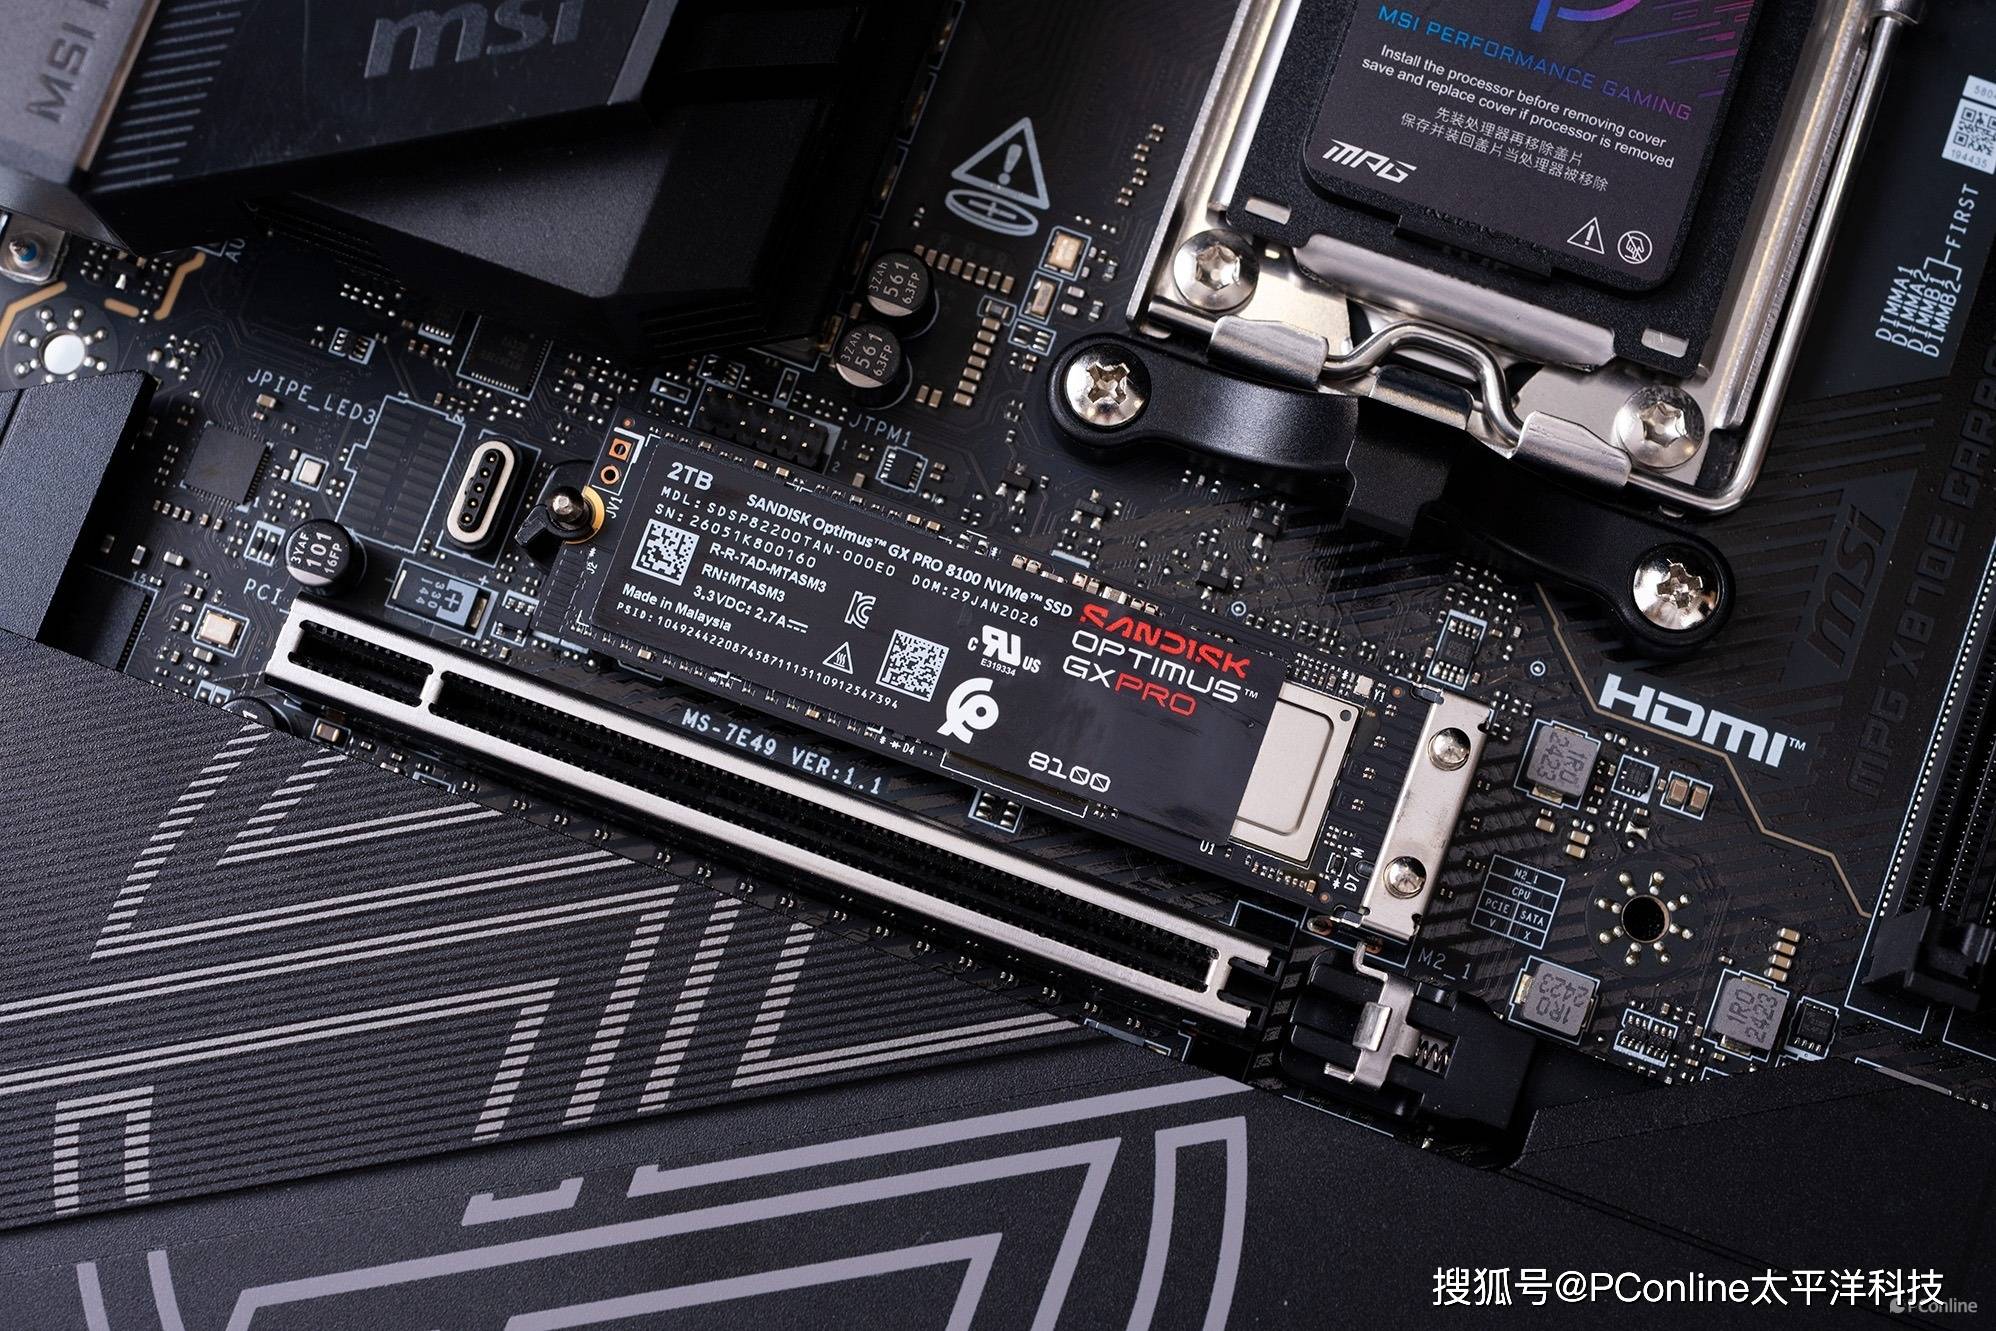
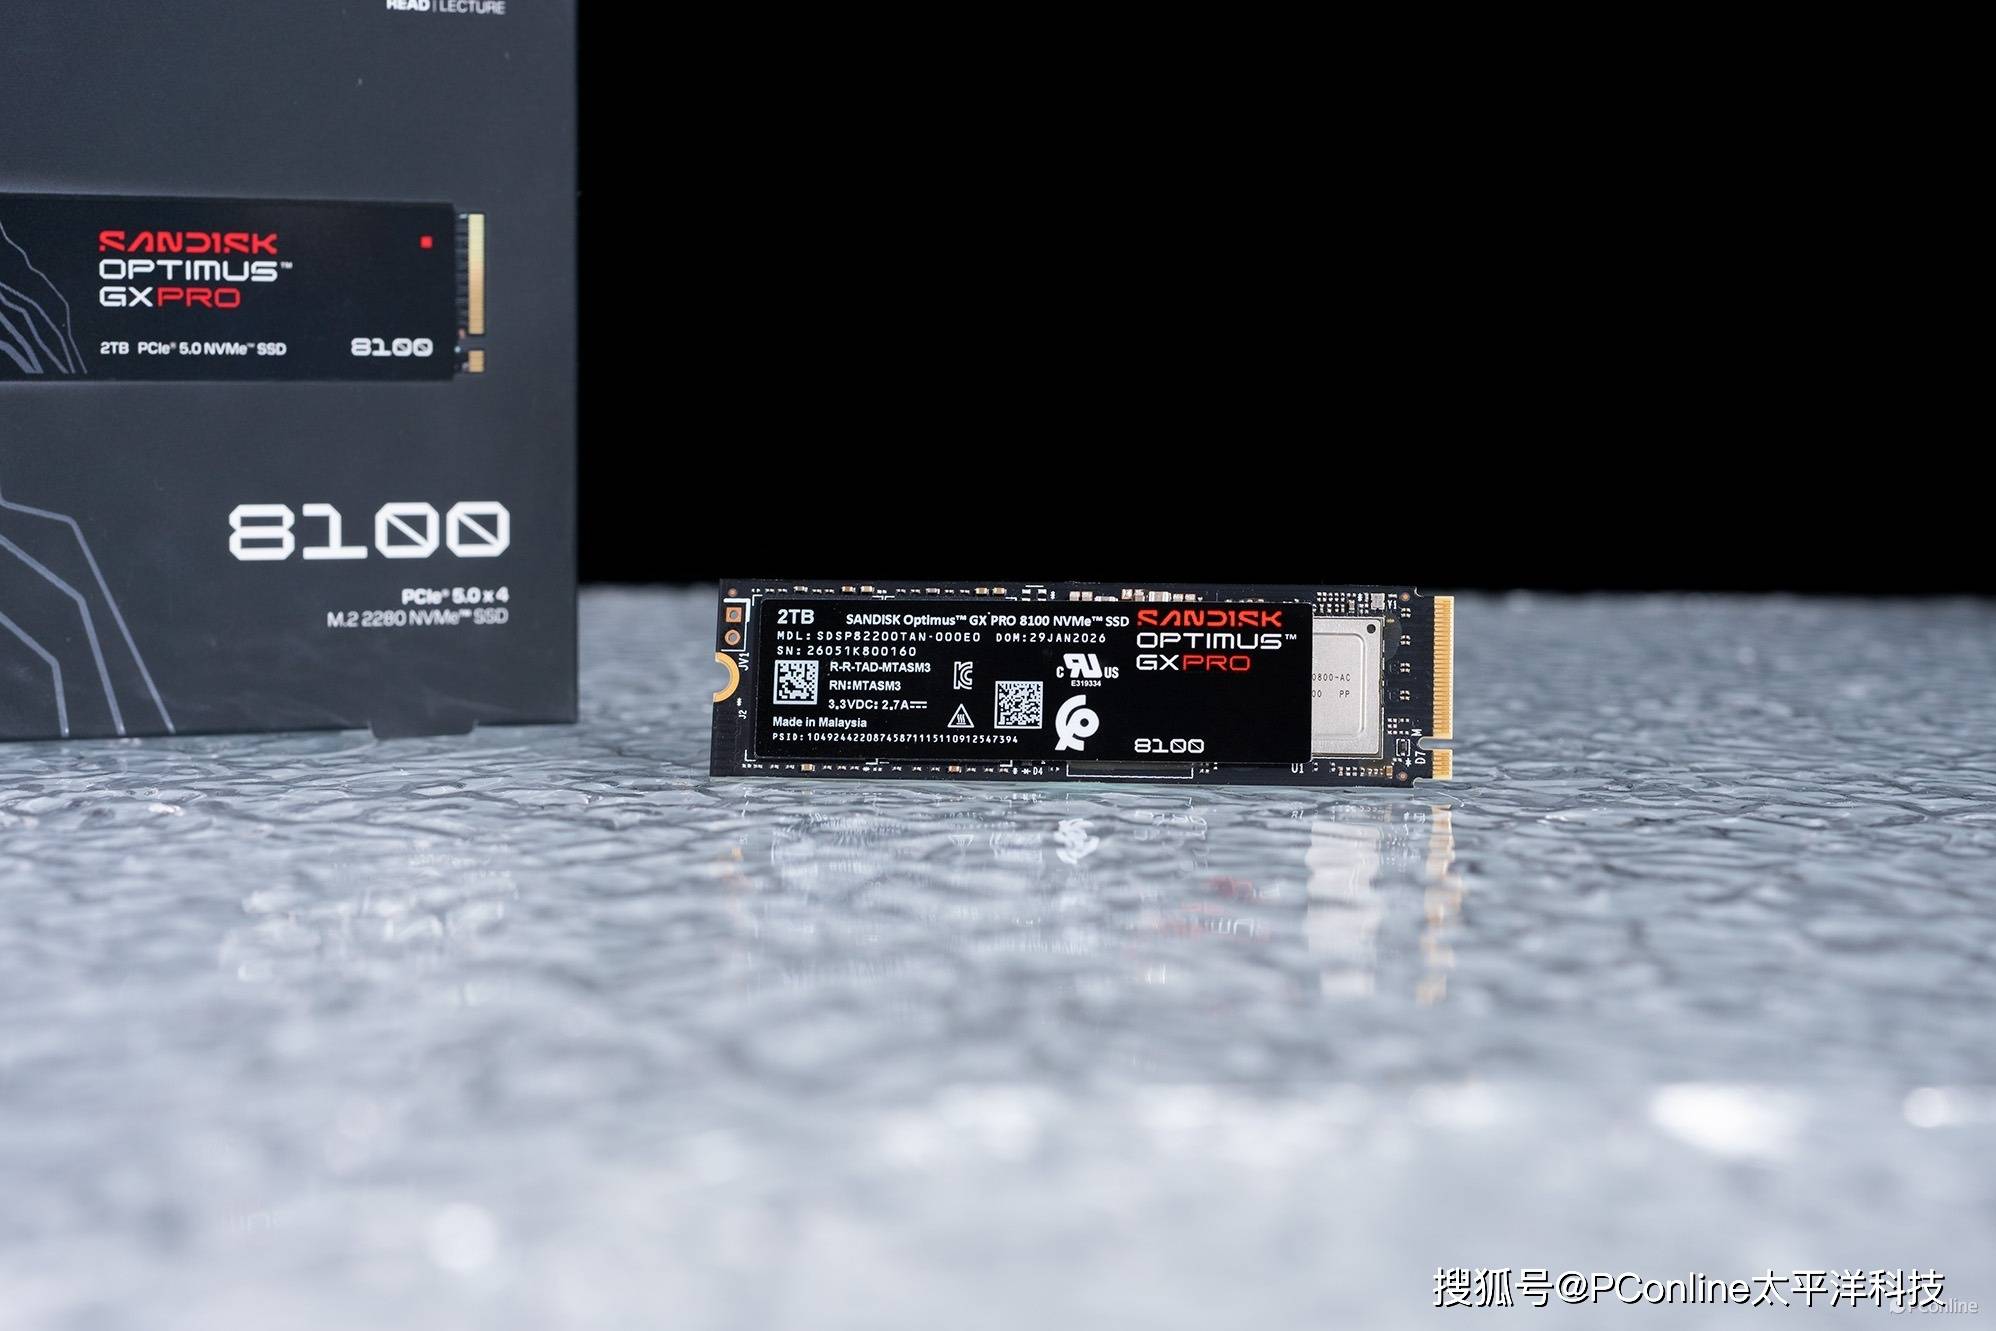
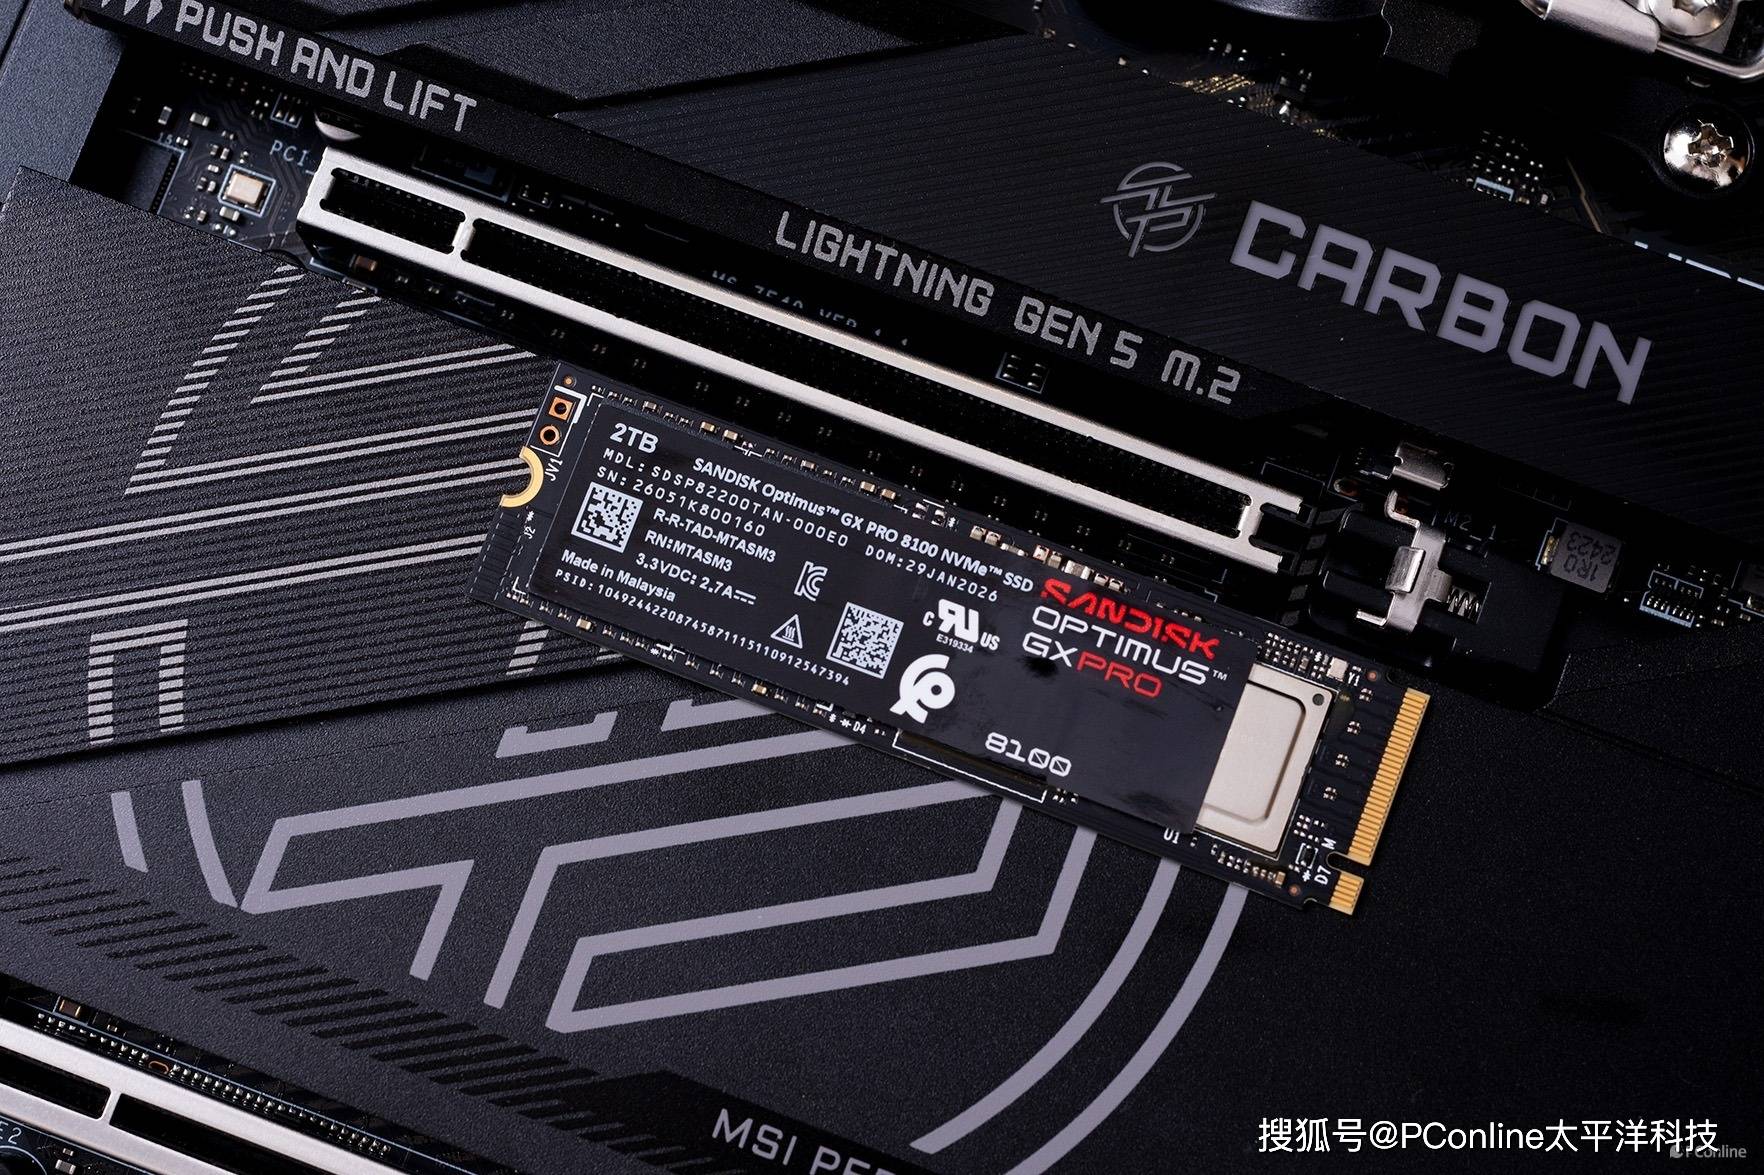
本次我们测试使用的闪迪奥丁马仕 GX PRO 8100是SANDISK Optimus闪迪奥丁马仕系列的旗舰产品,采用M.2 2280规格与PCIe 5.0 x4接口,支持NVMe 2.0协议,搭载闪迪第八代SANDISK BiCS TLC 3D CBA NAND闪存,配备独立DRAM缓存,并采用SANDISK nCache 4.0技术提升突发写入表现。
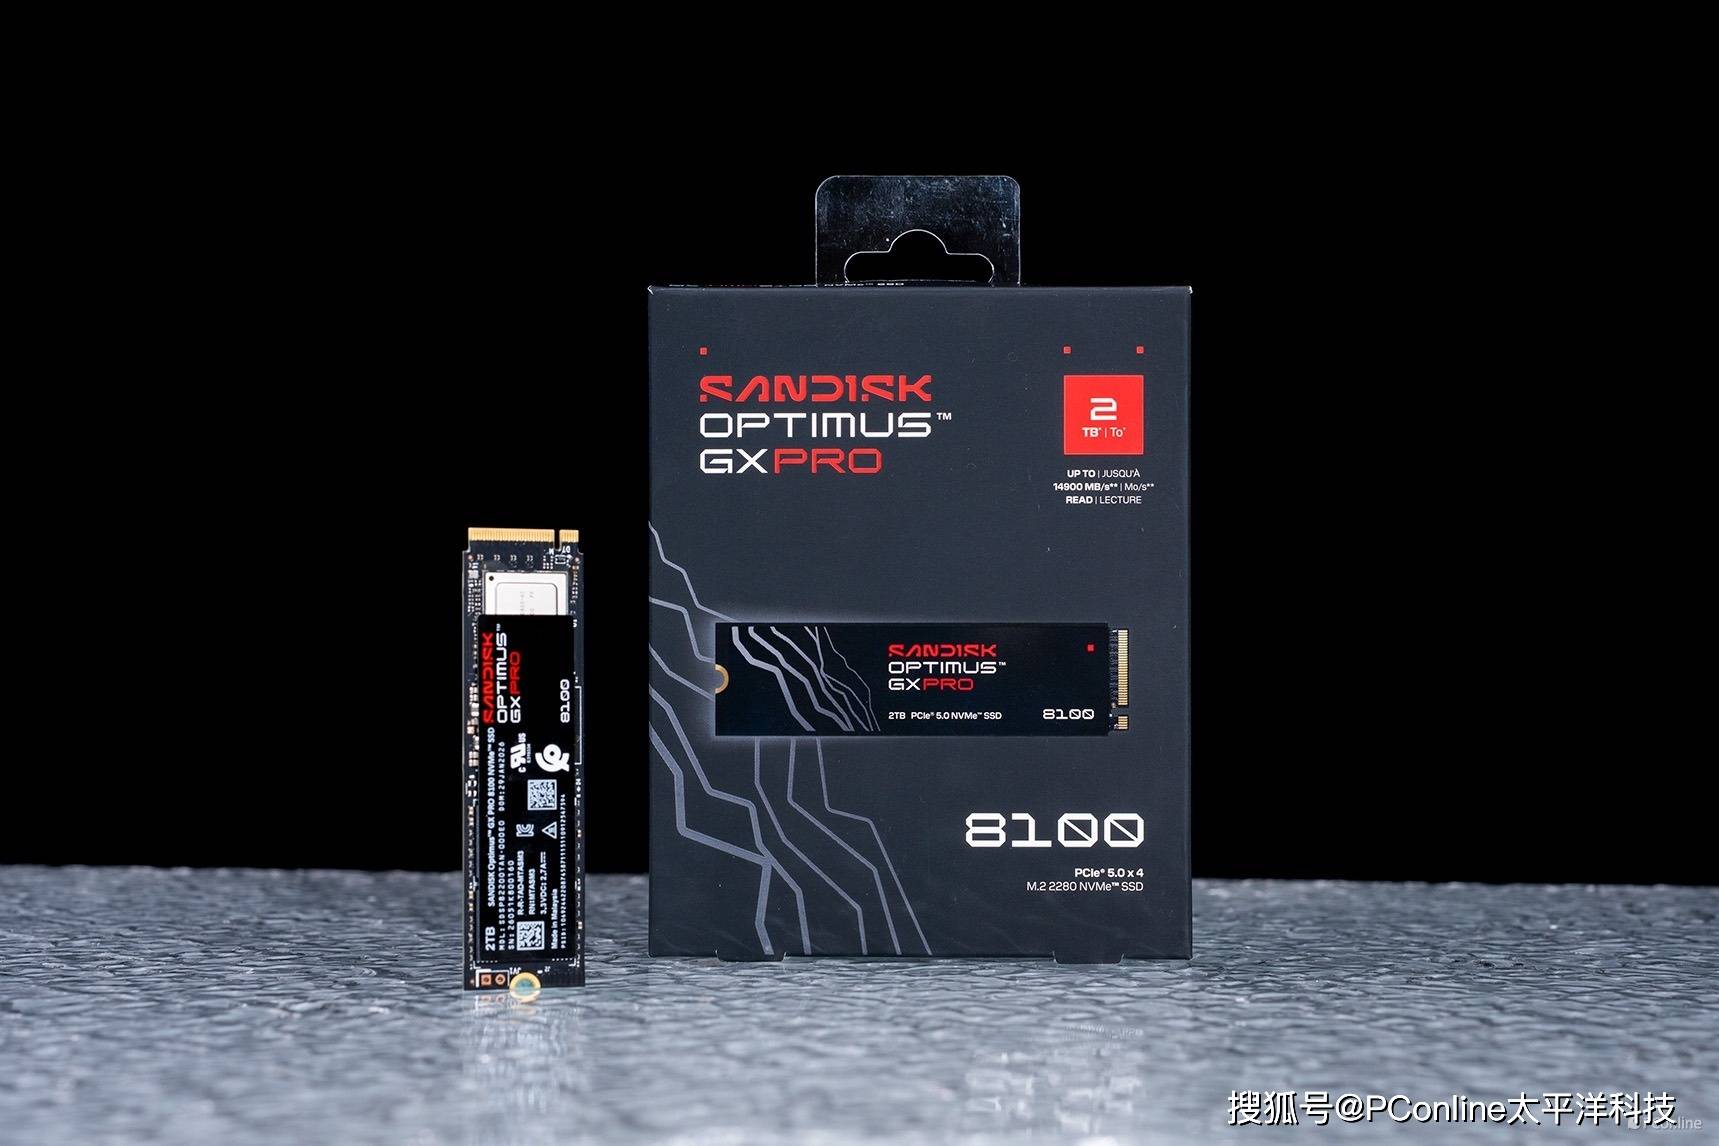
产品提供丰富容量版本可选,其中2TB与4TB容量版本的顺序读取速度高达14,900MB/s、顺序写入速度高达14,000MB/s,随机读写性能高达2.3M/2.4M IOPS——这组数字在当前的消费级SSD市场中处于绝对的第一梯队。
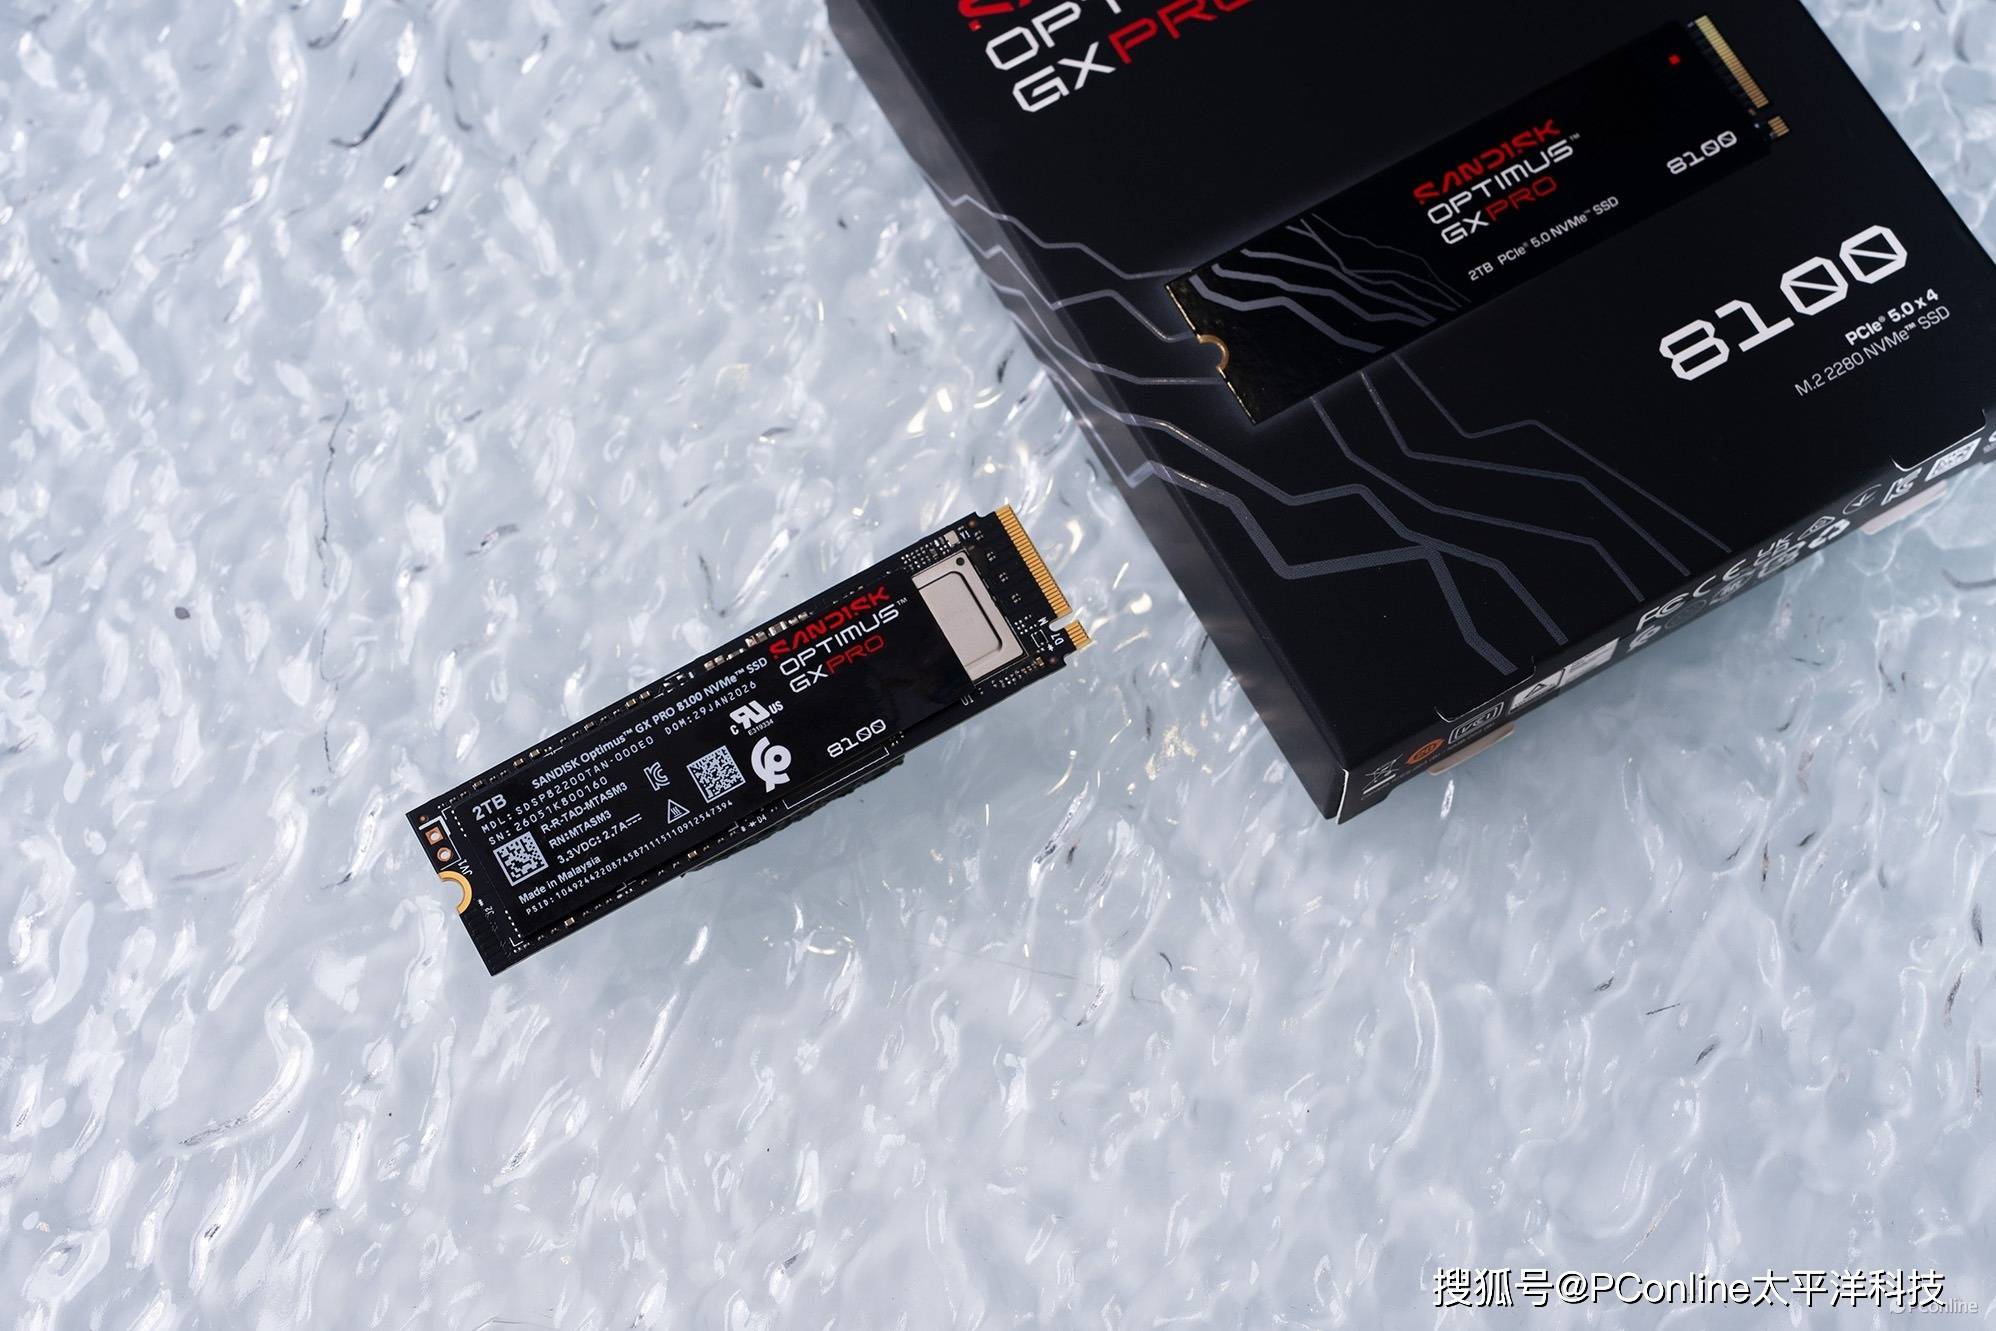
能效方面,相较于闪迪PCIe Gen 4.0 SSD,这款产品的能效提升超过2倍(1TB至4TB容量版本),平均运行功耗可控制在7.5W或更低。耐久度方面,以我们手上这款2TB容量版本的为例,其拥有高达1,200TBW耐久度,配合5年有限质保与支持TCG Opal v2.02的静态数据加密能力,完全是为高强度写入密集型工作负载量身打造。
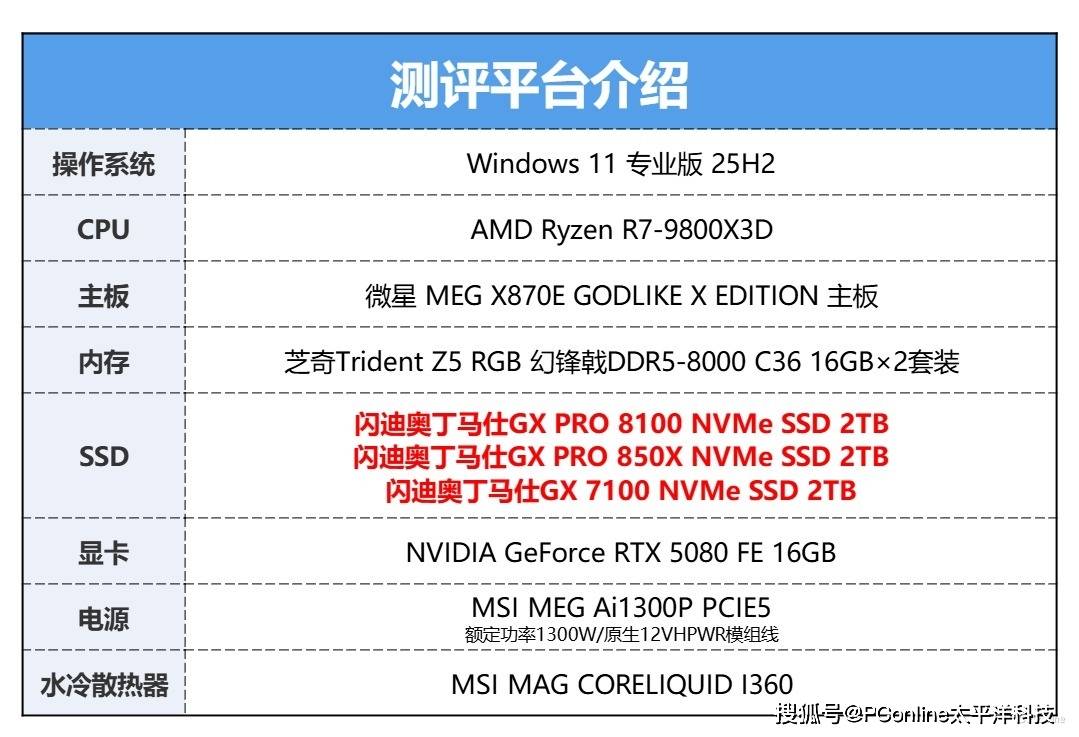
再介绍一下我们本次的实测平台:处理器为AMD Ryzen 7 9800X3D,主板为微星MEG X870E GODLIKE X EDITION超神,显卡为NVIDIA GeForce RTX 5080,内存为DDR5-8000 16GB×2套装,测试样品为闪迪奥丁马仕 GX PRO 8100 2TB容量版本,操作系统为Windows 11,所有AI应用与模型文件均部署在该SSD上。
测试软件方面,基准性能使用CrystalDiskMark 8与TxBENCH,本地大模型运行环境为LM Studio,知识库构建使用AnythingLLM,语音转写则使用基于Whisper模型的Buzz。
基准性能测试
我们先通过CrystalDiskInfo与主控闪存识别工具看了看这块SSD的"底子"。CrystalDiskInfo信息显示,这块闪迪奥丁马仕 GX PRO 8100 2TB实际可用容量为2000.3GB,固件版本830ZRR0A,正确运行在PCIe 5.0 x4全速模式下,支持NVMe 2.0标准,开箱健康度100%,待机温度仅31°C。
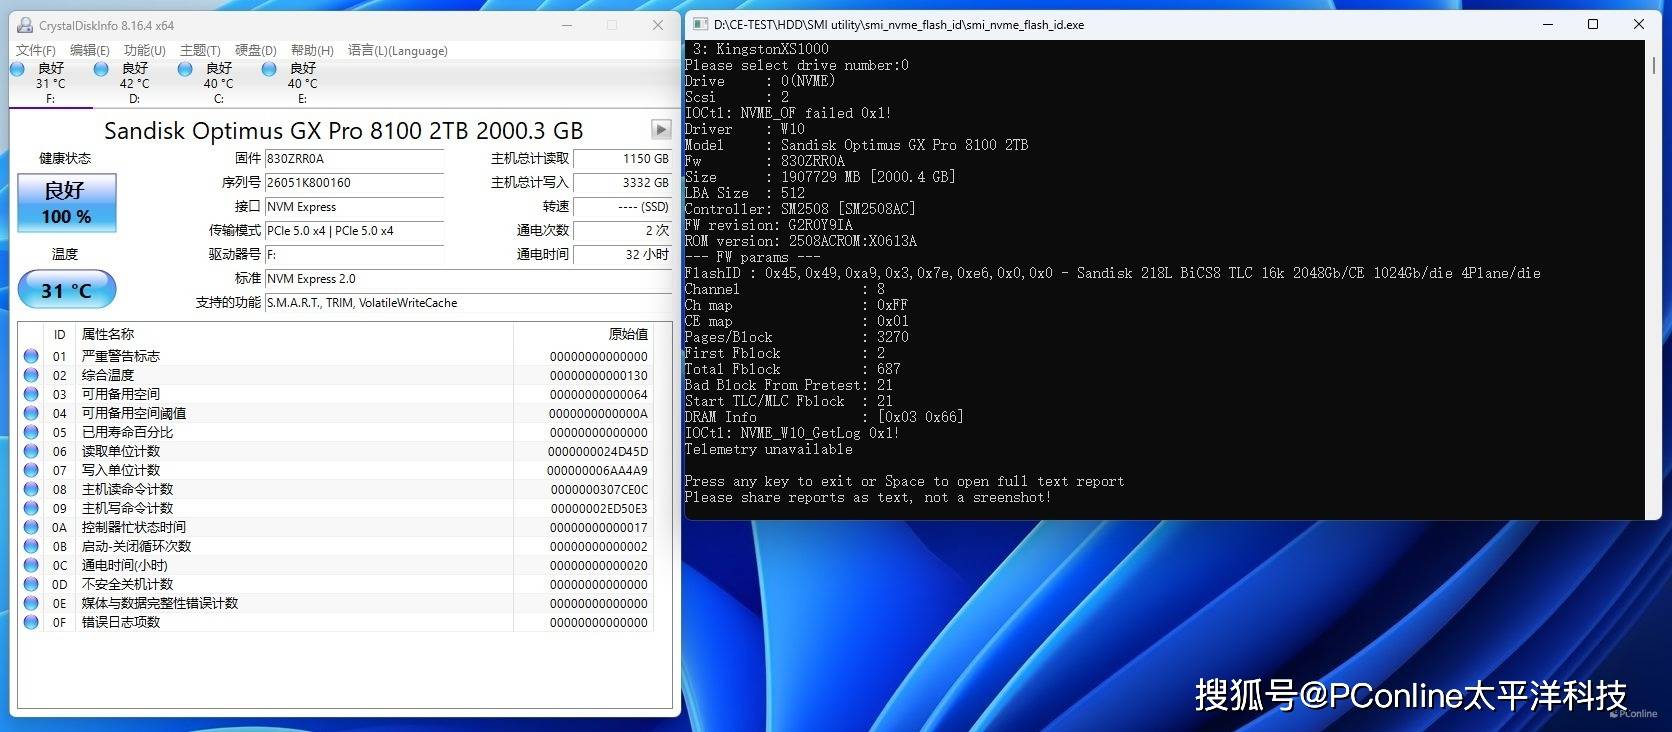
另外,我们还可以从图中看到这款SSD的主控采用慧荣SM2508八通道旗舰主控,闪存颗粒则是闪迪自家218层BiCS8 TLC闪存,单die容量1024Gb、4 Plane设计。这套"八通道旗舰主控+原厂218层TLC颗粒"的组合,正是当前PCIe 5.0 SSD中的顶级配置,既为逼近15GB/s的顺序速度提供了通道与颗粒基础,也为其出色的能效表现埋下了伏笔。
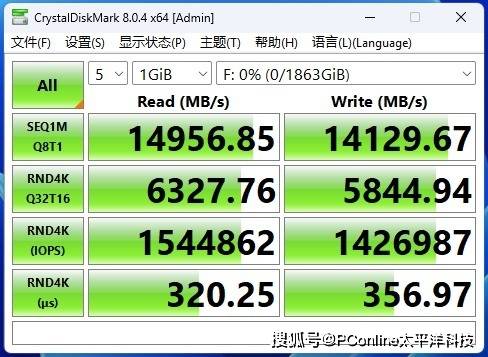
接着我们再用CrystalDiskMark 8对这块闪迪奥丁马仕 GX PRO 8100 2TB进行了理论性能验证。实测结果显示,其顺序读取速度达到14957MB/s,顺序写入速度达到14130MB/s,双双超过了官方标称值。
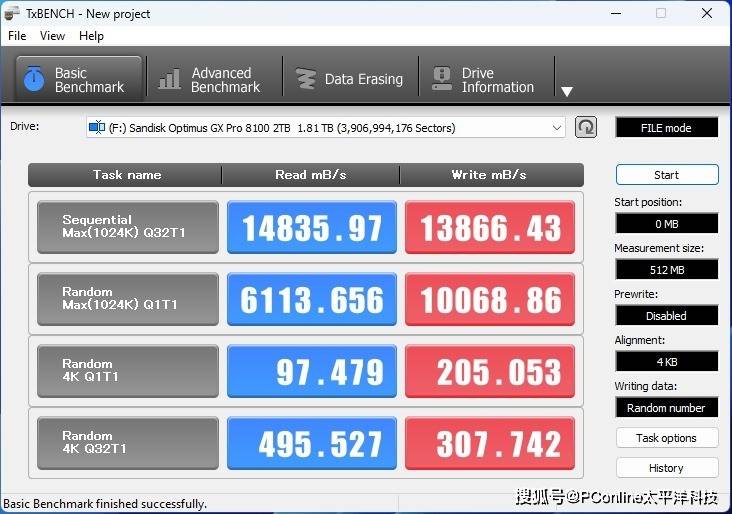
而在TxBENCH的交叉验证中,该盘顺序读写速度同样跑出14,836/13,866MB/s的高水准。
为了进一步探究这块SSD在极限写入状态下的表现,我们还使用TxBENCH对其进行了RAW全盘写入测试,结果揭示了SANDISK nCache 4.0技术的底气所在:这块2TB容量版本的闪迪奥丁马仕 GX PRO 8100拥有高达约628GB的SLC缓存空间,在缓存区间内写入速度可以稳定维持在14,000MB/s左右的全速状态;即便628GB缓存耗尽进入缓外直写阶段,写入速度依然能够稳定在约4,000MB/s的水平,没有出现断崖式下跌。全盘写入过程中,SSD温度最高仅约61°C,全程未触发过热降速。
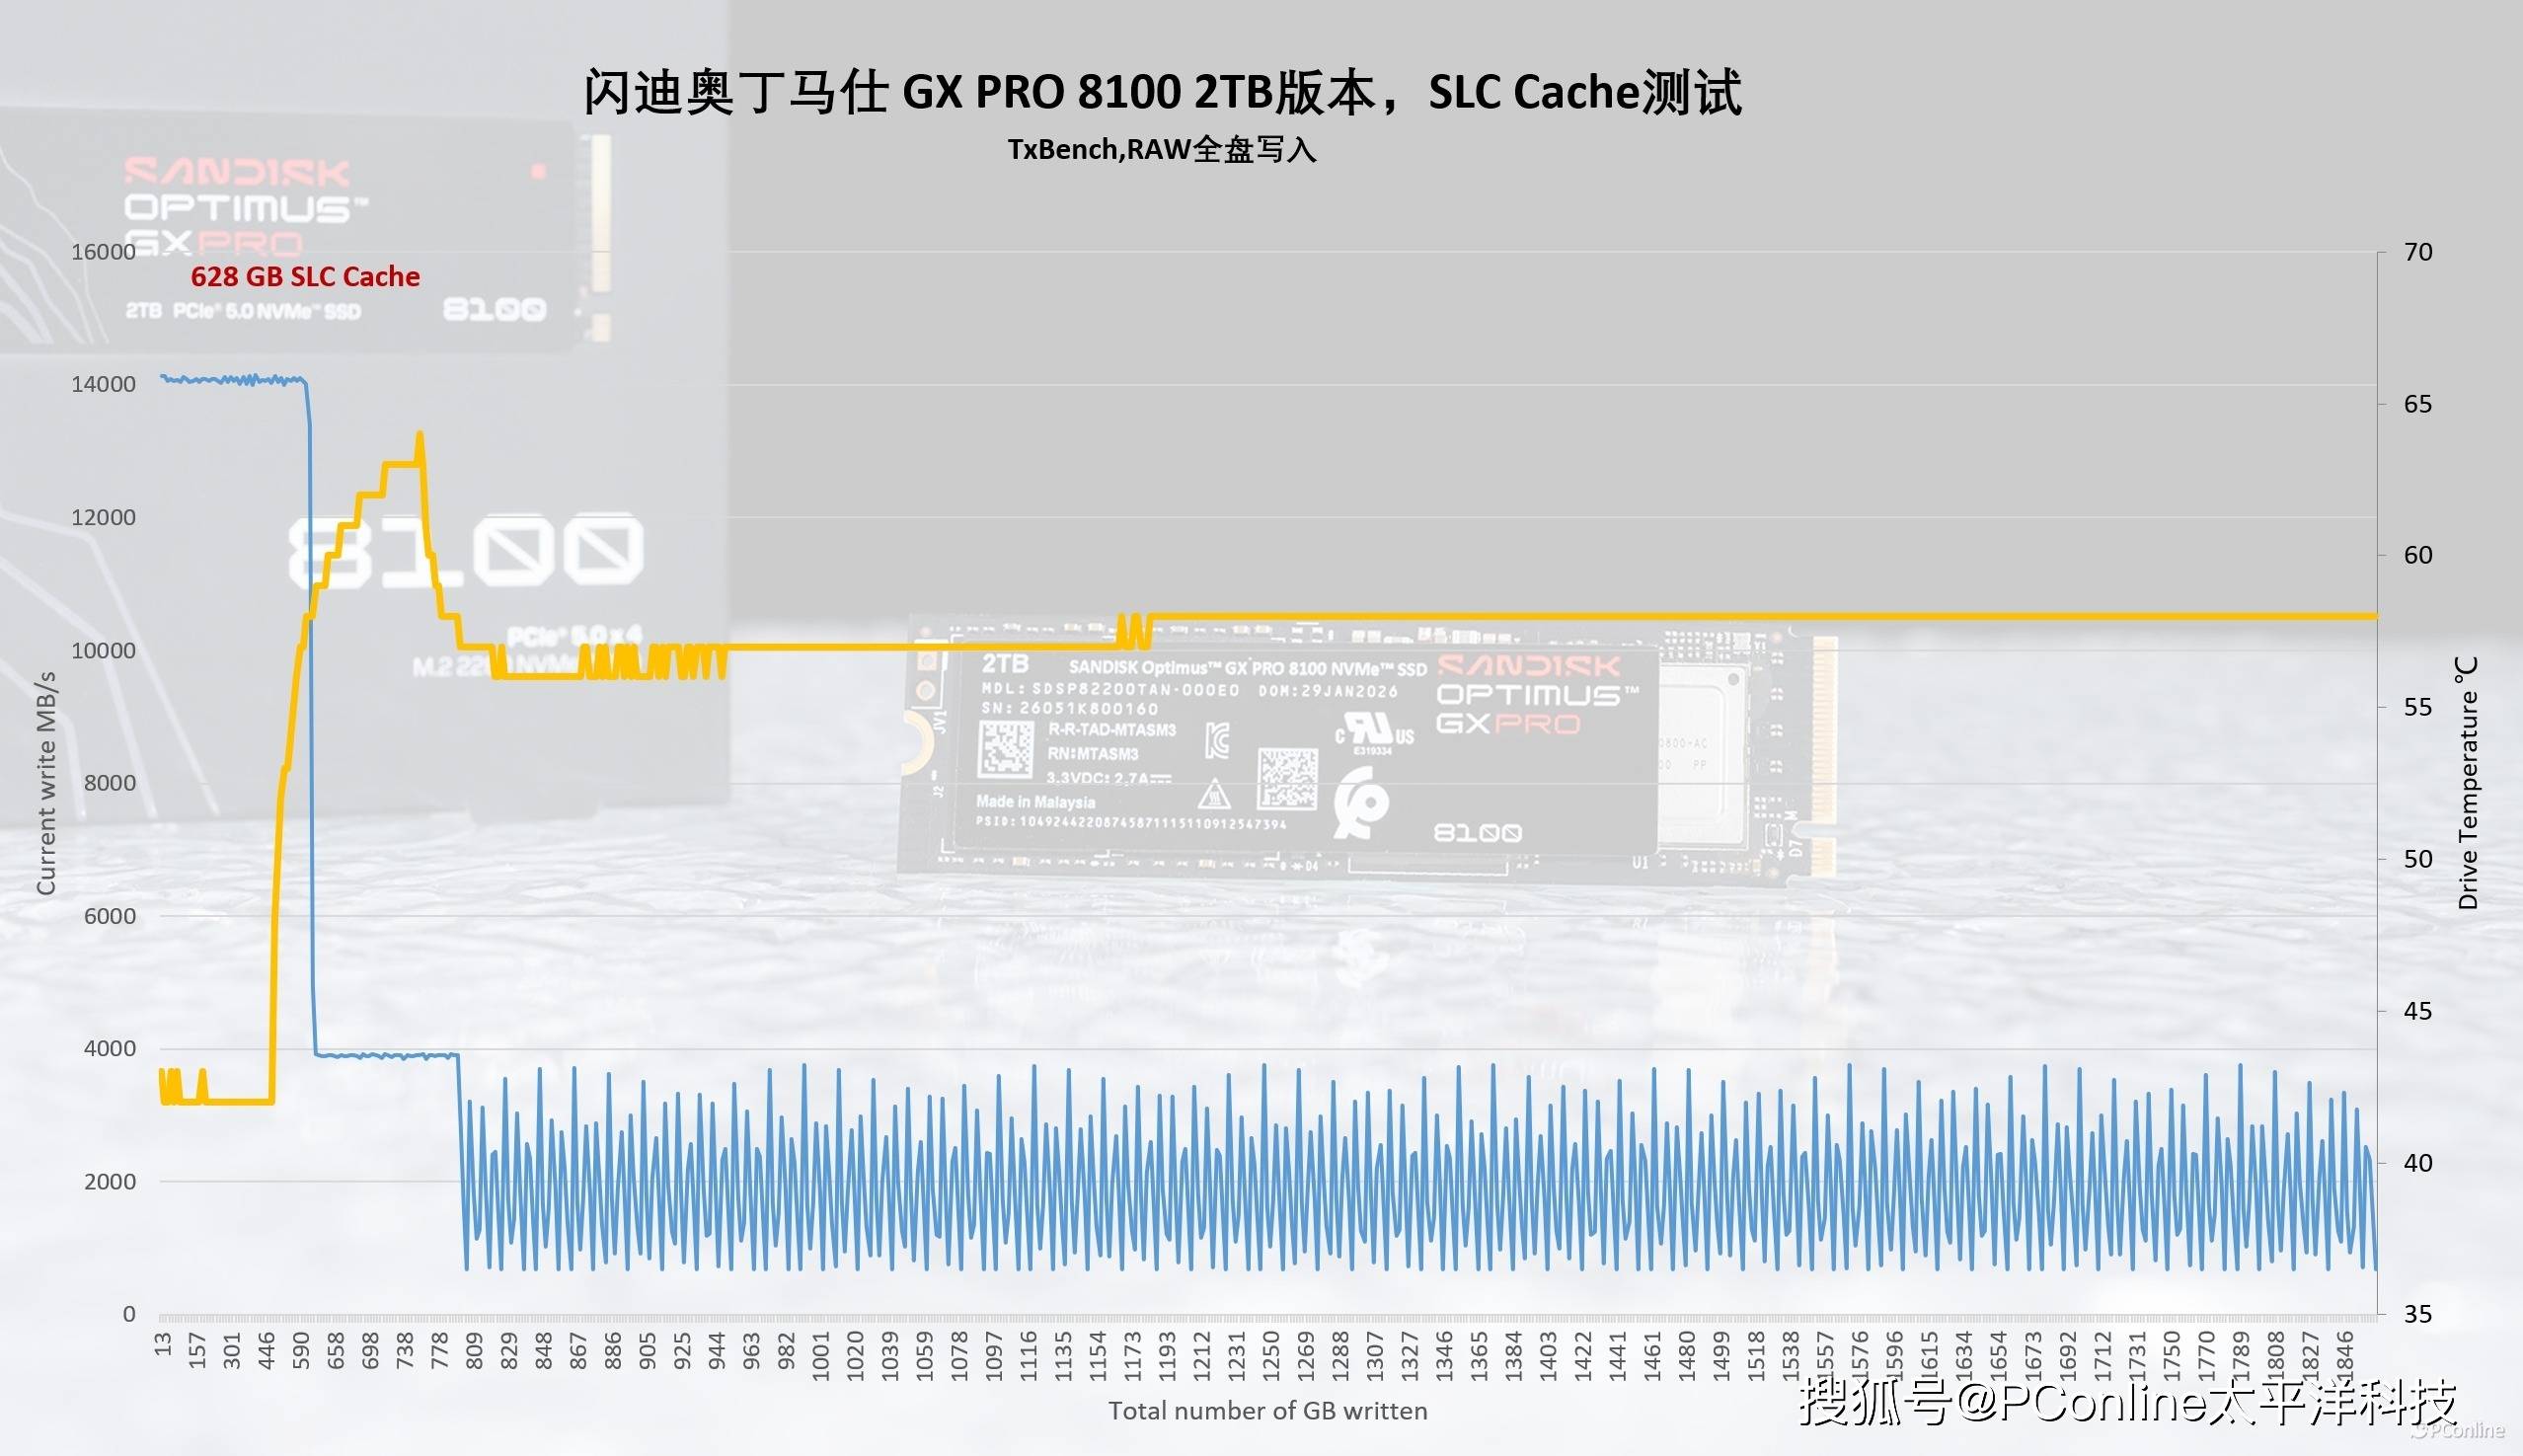
即便你一次性向SSD灌入整个70B级别的模型库外加数百GB的数据集,也始终跑在全速缓存区间内——对于AI场景动辄数十GB的模型文件迁移而言,日常使用中几乎不可能触达它的缓外状态。那这款SSD在真实AI场景中究竟又能带来多大的体验差异?一起跟我们看看下面的实测吧。
实测一:本地大模型加载,等待时间缩短一半以上
本地AI体验的第一个分水岭,就是模型加载速度。我们在测试平台上部署了基于LM Studio的本地模型运行环境,选取了四个当下最热门的开源模型进行加载测试:DeepSeek-R1蒸馏版4B、DeepSeek-R1蒸馏版14B、DeepSeek-R1蒸馏版32B,以及Qwen3.8-27B。测试方法为冷启动加载:每次测试前清空系统缓存,从点击加载到模型完全载入就绪、可以开始首轮对话为止,用秒表精确计时。
首先是DeepSeek-R1蒸馏版4B。这是四个模型中体积最小的一个,也是许多用户入门本地AI的第一个模型。实测中,它在闪迪奥丁马仕 GX PRO 8100 2TB版本上的加载耗时约4.33秒,几乎是在点击加载的瞬间就完成了就绪。对于轻量级的日常问答、快速翻译这类高频调用场景来说,你几乎感觉不到"加载"这个环节的存在。
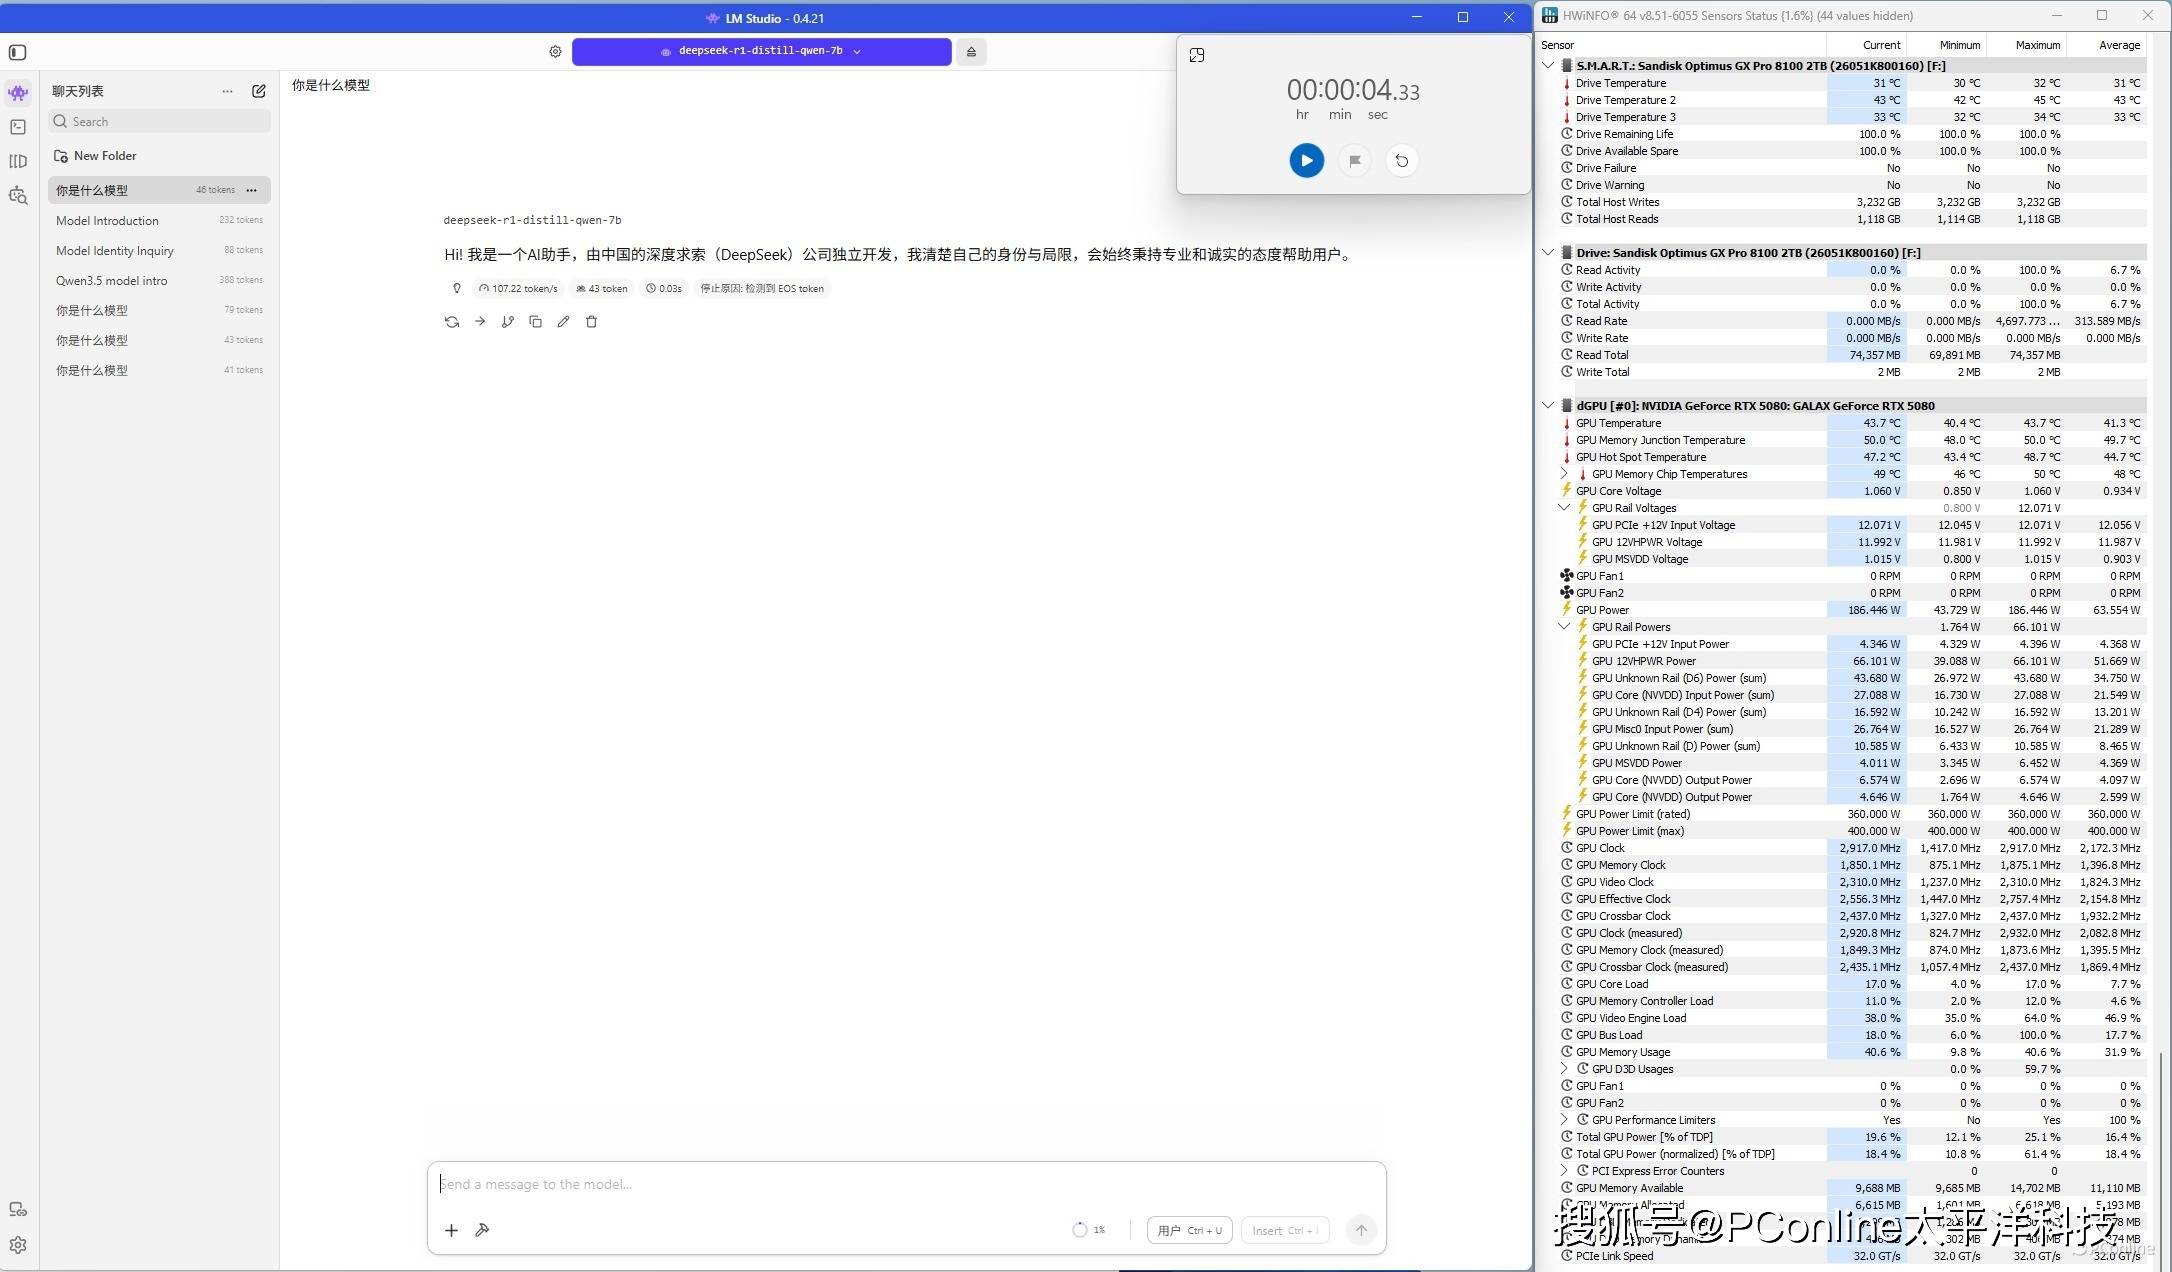
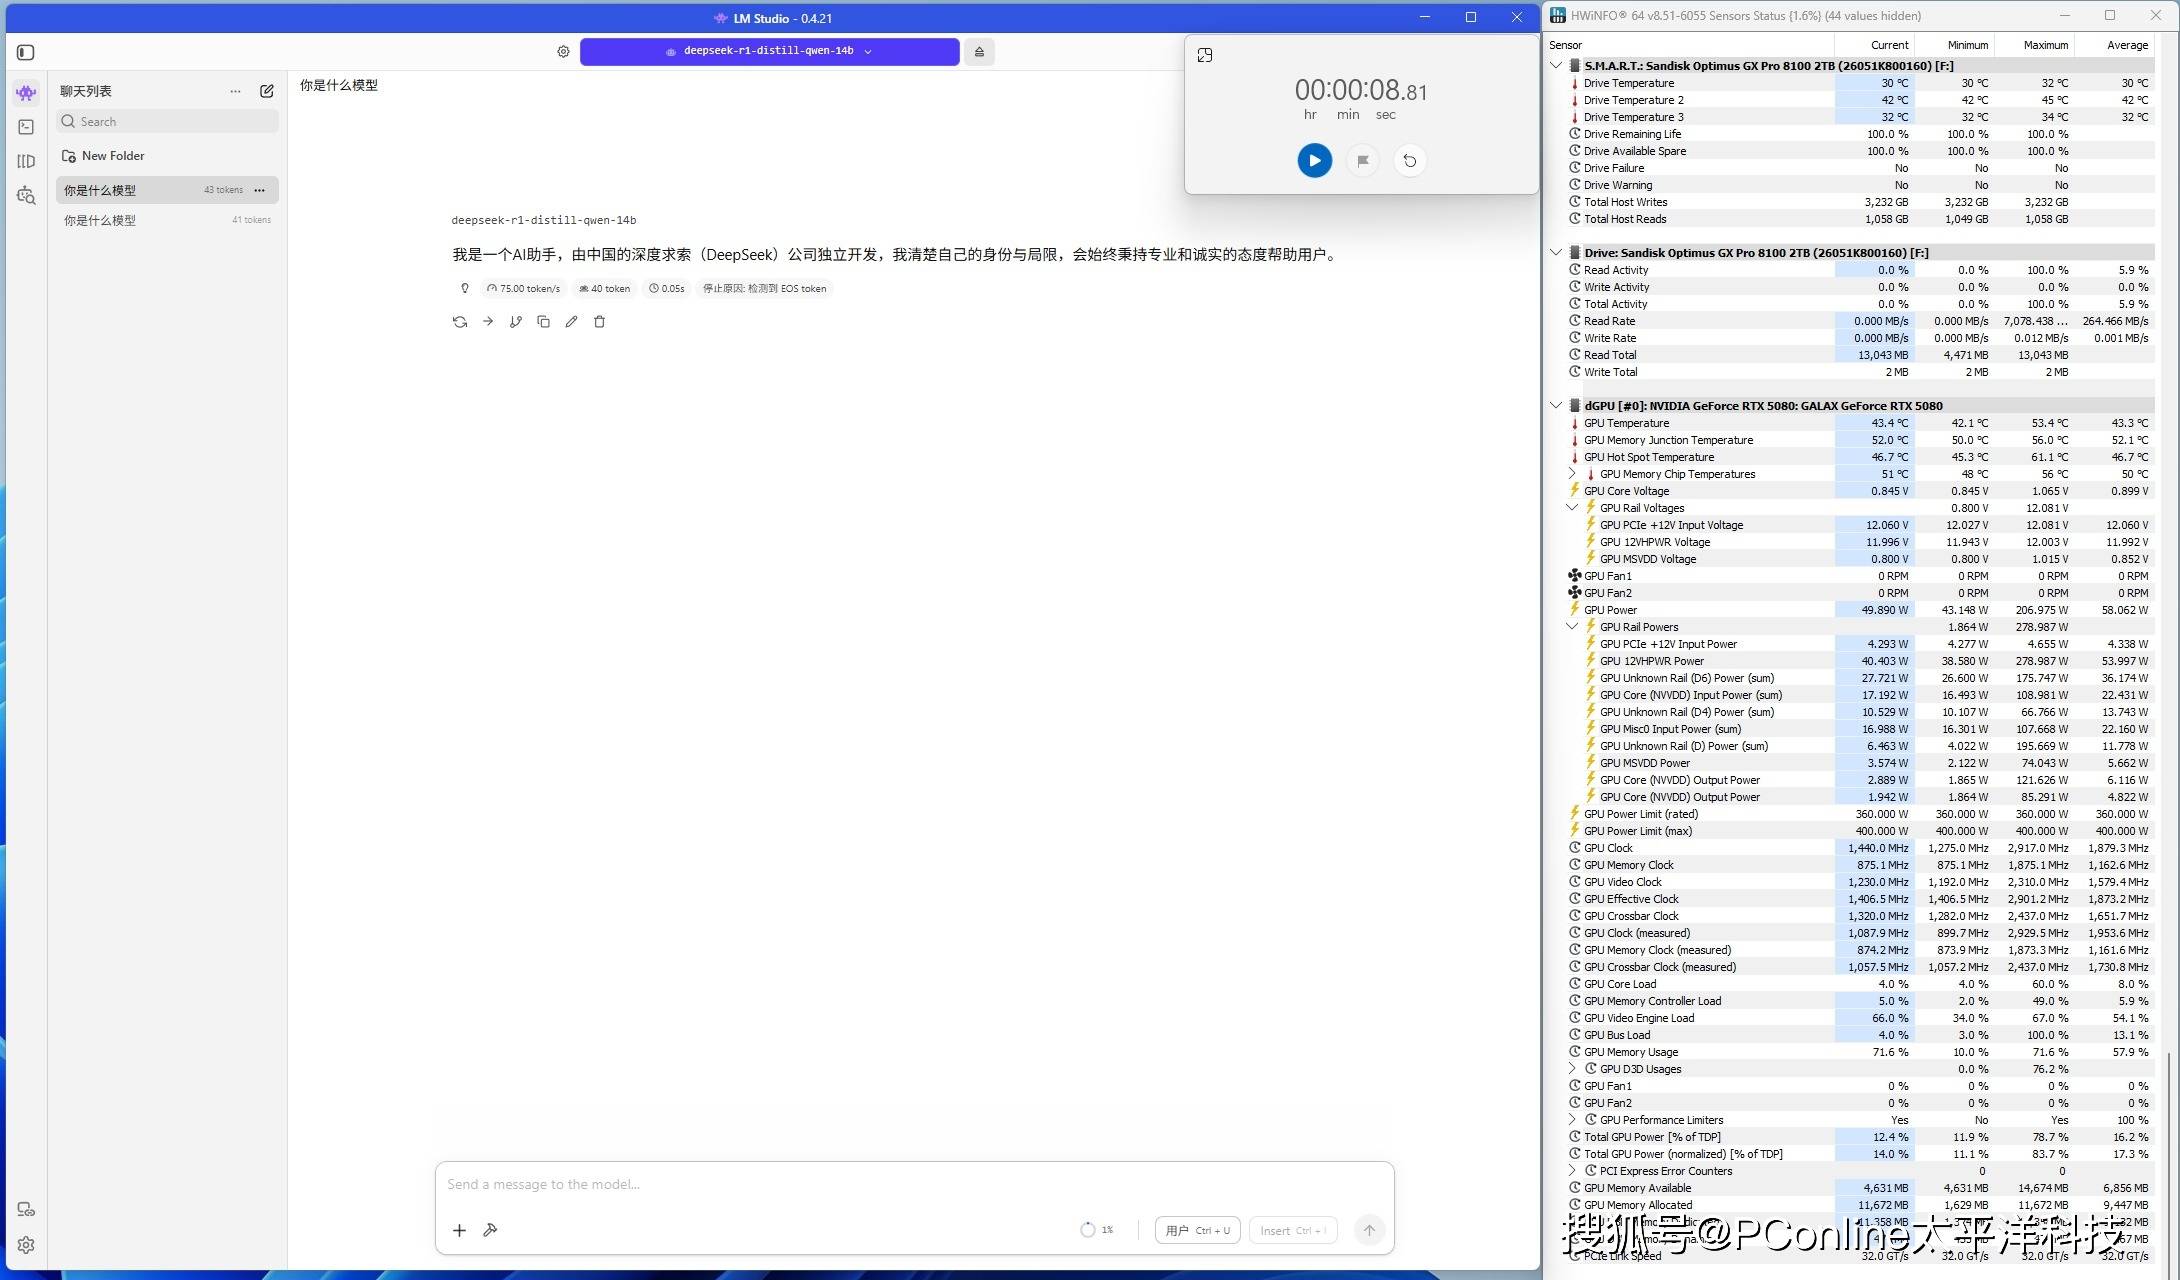
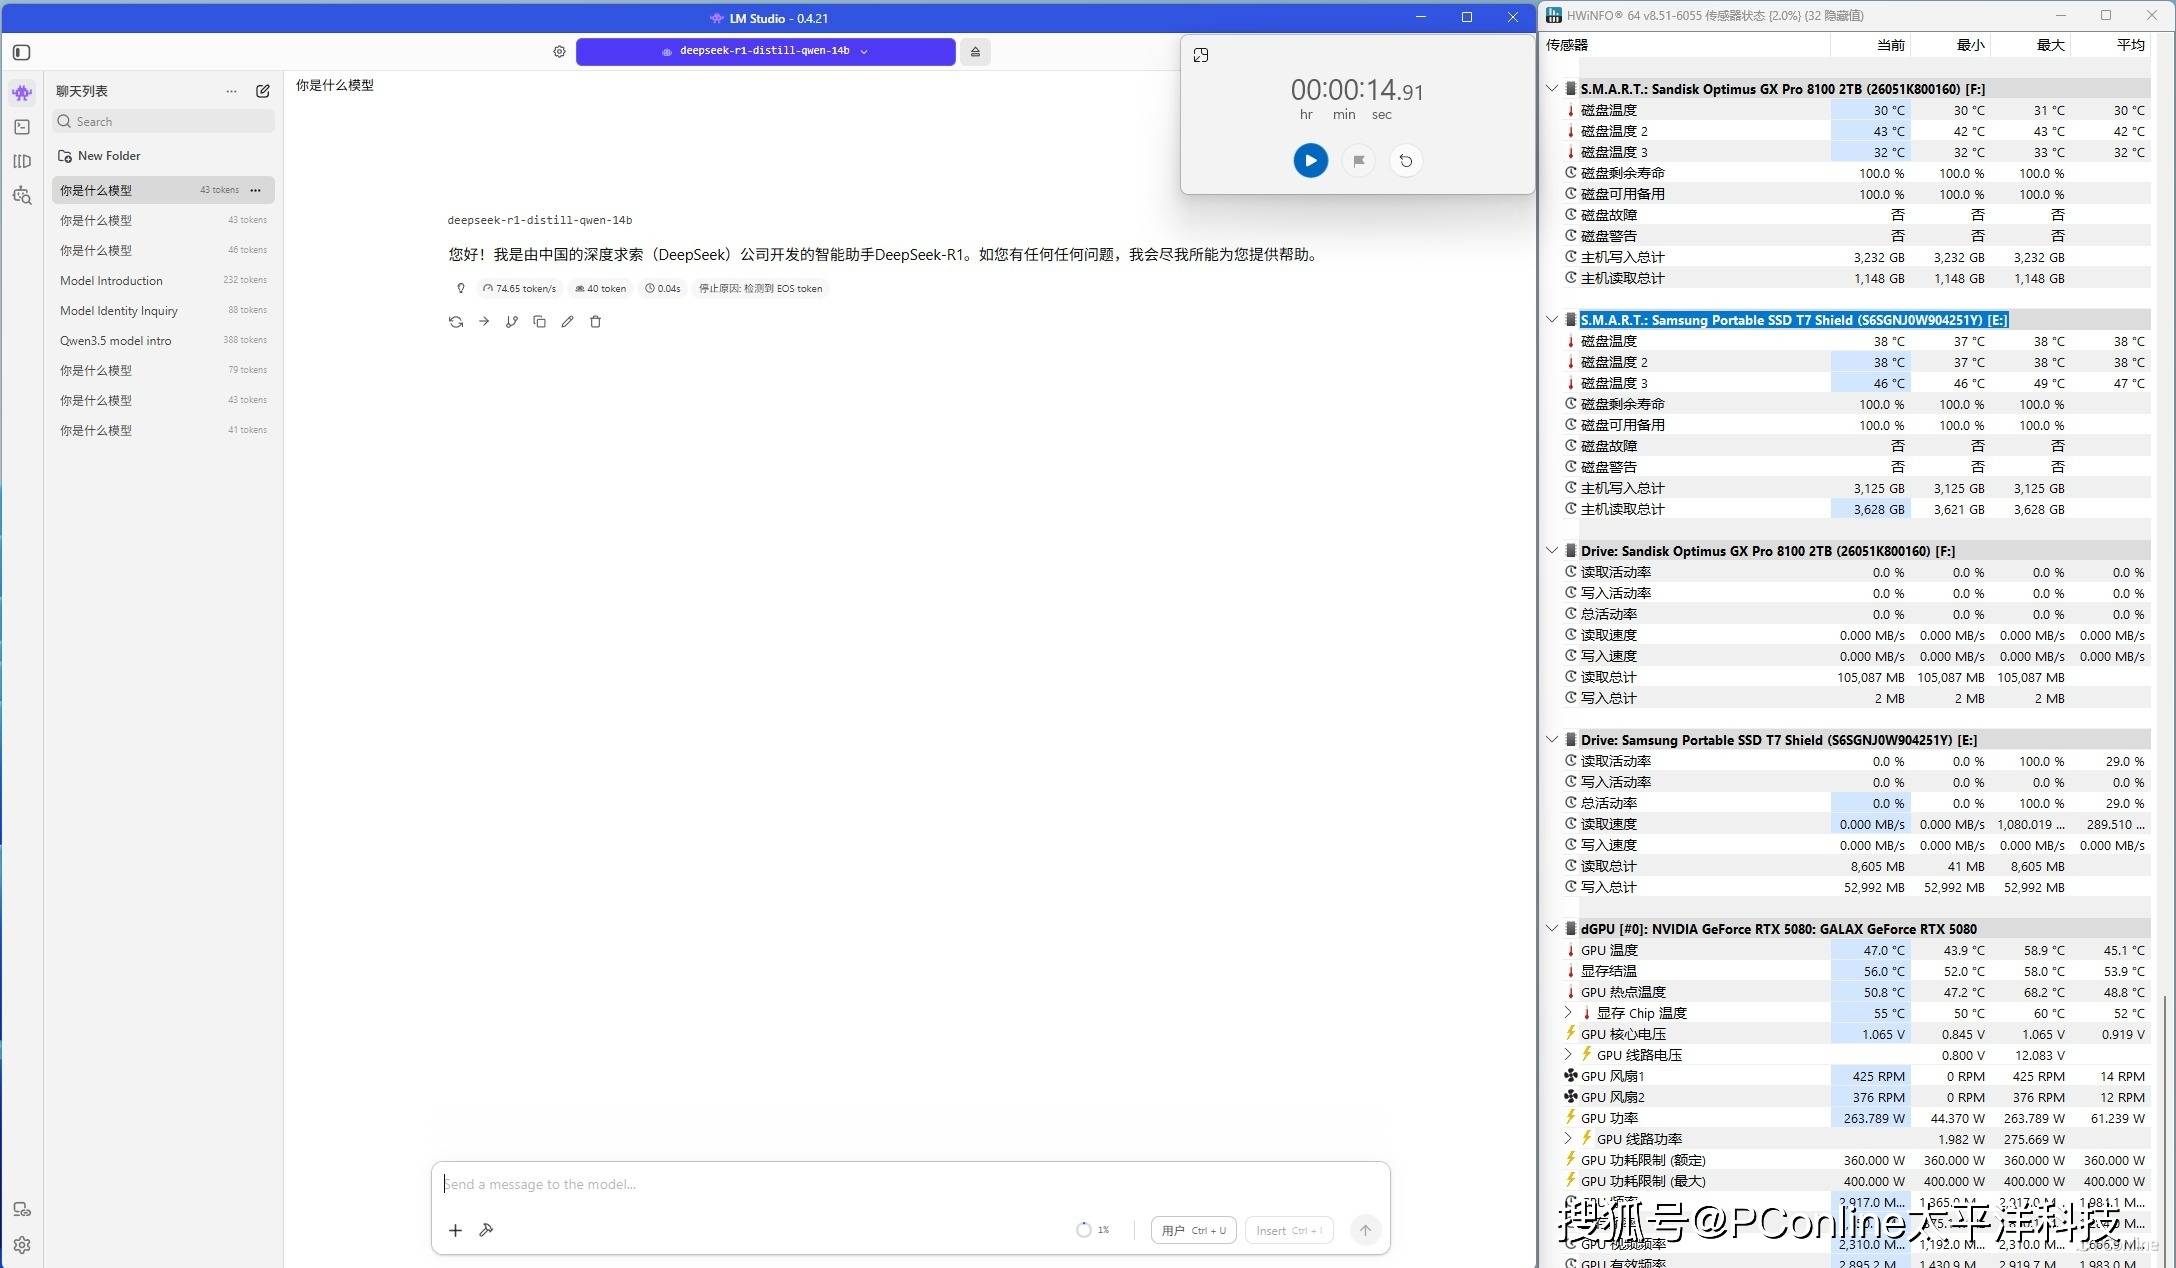
接下来是DeepSeek-R1蒸馏版14B。这是目前兼顾回答质量与硬件门槛的热门甜点级模型,参数规模上来之后,模型文件体积明显增大,对存储读取速度的要求也随之提高。实测中,它在闪迪奥丁马仕 GX PRO 8100 2TB版本上的加载耗时约8.81秒。
作为对照,同一个模型在普通移动固态硬盘上加载需要约14.91秒——差距接近一倍,存储带宽的作用开始显现。
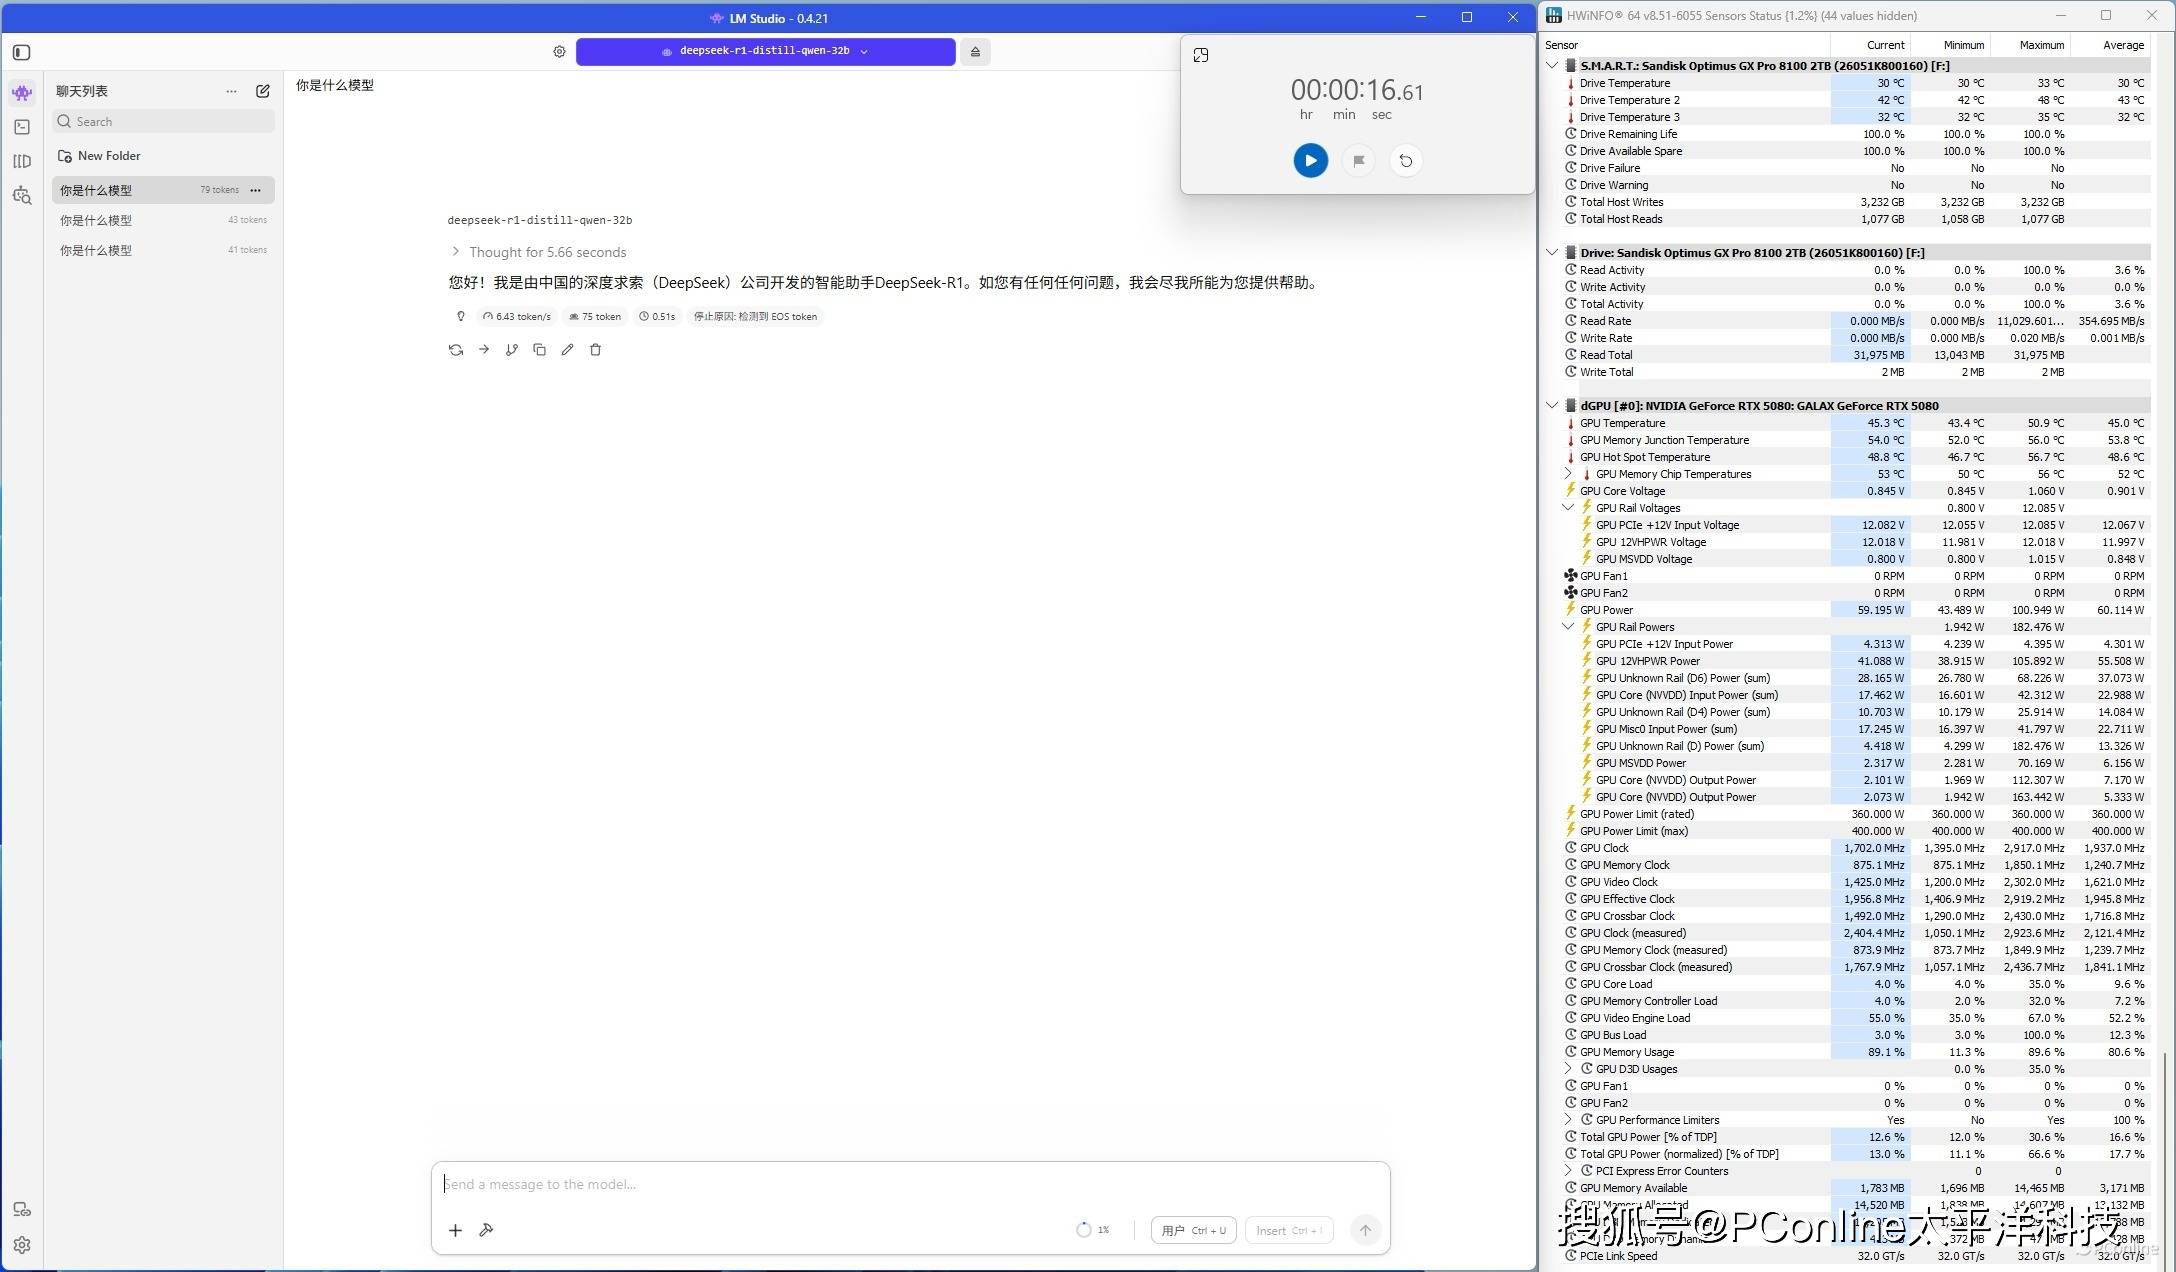
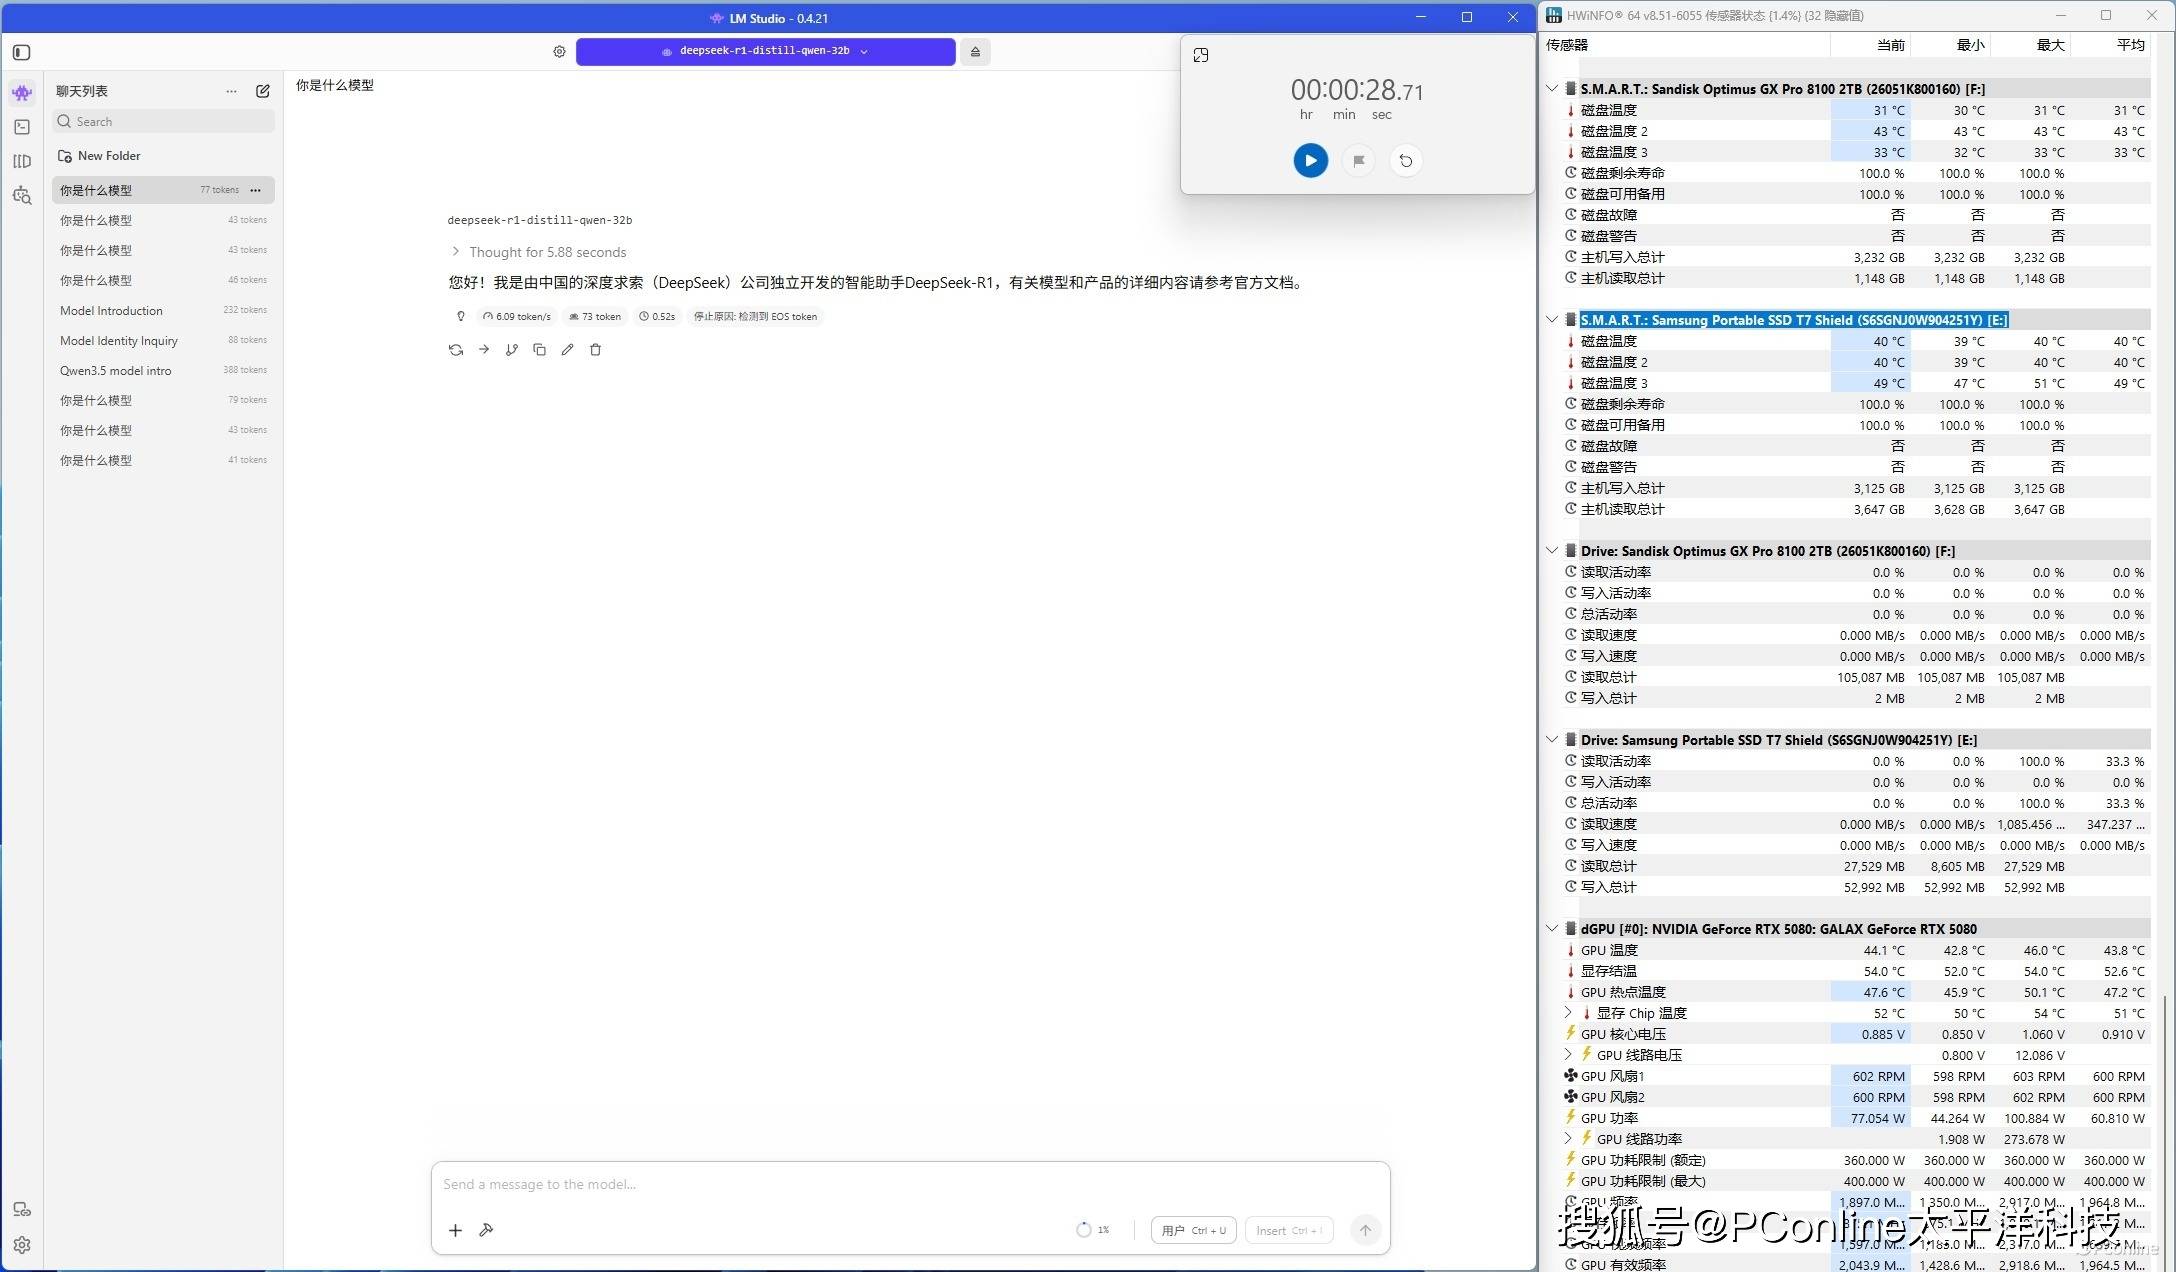
然后是DeepSeek-R1蒸馏版32B。这已经是消费级平台上能够流畅运行的顶级参数规模之一,模型文件接近20GB,是检验存储性能的绝佳样本。实测中,它在闪迪奥丁马仕 GX PRO 8100 2TB版本上的加载耗时约16.61秒,逼近20GB的模型文件在十几秒内被完整读入,顺序读取速度的硬实力展露无遗。
而同一个模型在普通移动固态硬盘上需要约28.71秒才能就绪——等待时间被拉长到将近两倍,每次切换模型都得多等十几秒。
最后是近期火热的Qwen3.8-27B模型。它的模型文件体量与32B级别相当,同样是存储性能的压力测试。实测中,它在闪迪奥丁马仕 GX PRO 8100 2TB版本上的加载耗时约14.84秒。
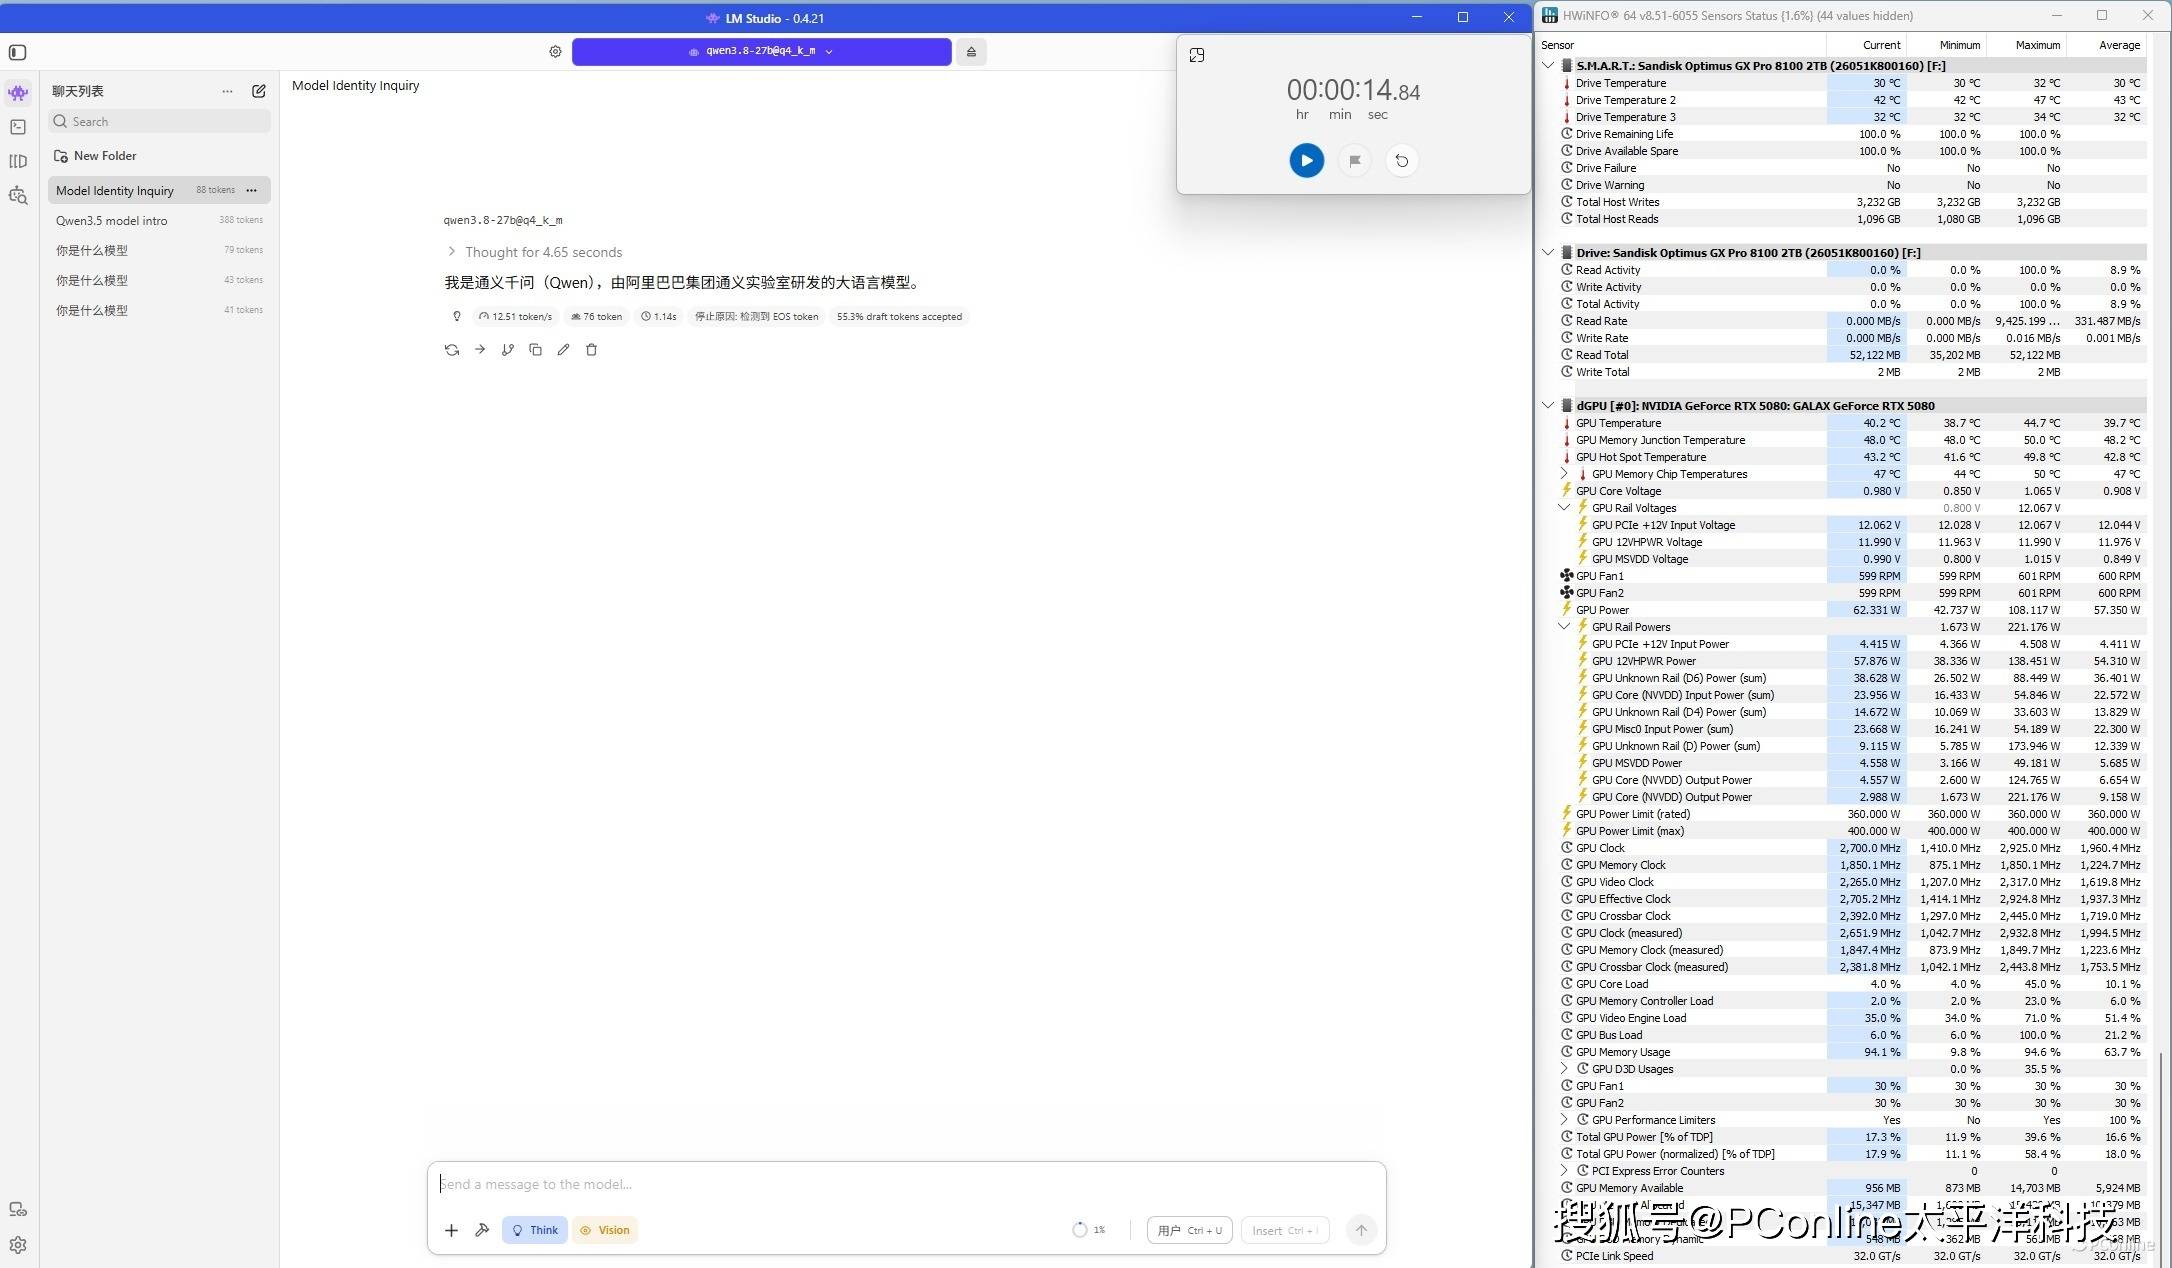
而在普通移动固态硬盘上,这个数字是约40.09秒——差距接近三倍。40秒的等待已经长到足以打断工作思路,而14秒则刚好是切换模型后顺理成章开始提问的节奏。
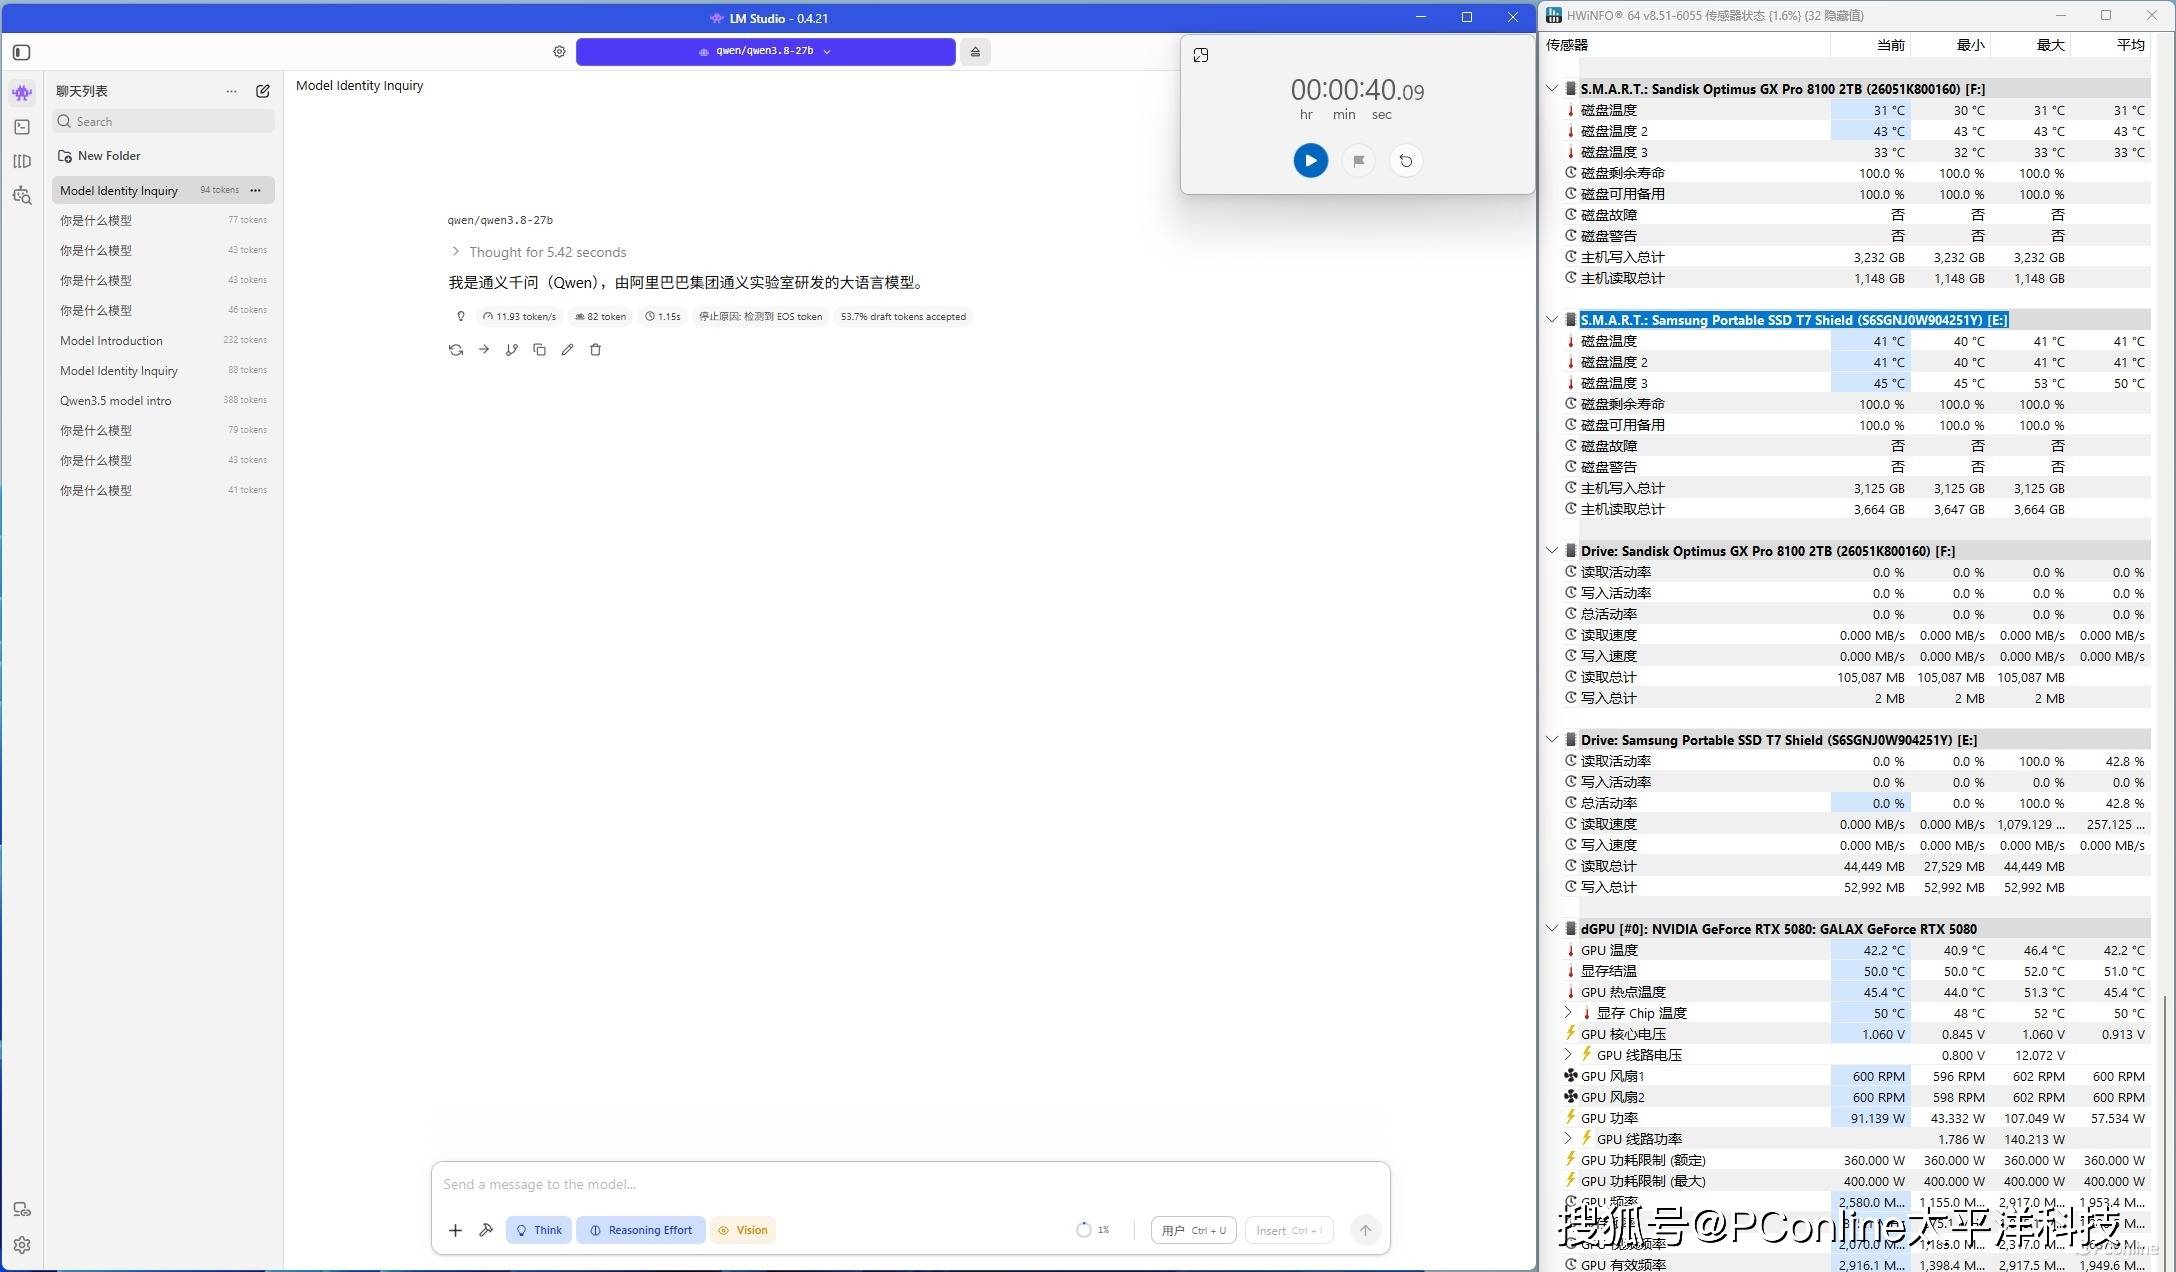
这组数据落到实际体验上的差异是直观的。对于把本地AI当作高频工具的用户来说,一天之内多次启动、切换模型是常态——写代码时用代码专精模型,整理资料时切换到通用对话模型,处理录音时再调用语音模型。在闪迪奥丁马仕 GX PRO 8100上,每次切换几乎是"即点即开",而在普通移动固态硬盘上,每次切换都要付出十几秒甚至半分钟的等待。更值得注意的是加载过程中的曲线形态:凭借SANDISK nCache 4.0技术与强悍的顺序读取能力,这块SSD的加载曲线几乎是一条平直的高速直线,全程没有出现明显的速度波动,而对比普通移动固态硬盘在加载后半段多次出现速率下探。这种一致性,恰恰是旗舰级主控与优质NAND闪存协同的结果。
实测二:大文件吞吐与知识库构建,海量数据从容流转
本地AI的第二类高负载场景,是数据集的搬运与知识库的构建。无论是把大量PDF文档、录音文件导入本地AI应用,还是构建个人知识库的向量索引,本质上都是对SSD的大文件读写与混合读写能力的考验。
我们模拟了一个典型的知识库构建任务:将总计100GB的混合文件从外置存储迁移至测试盘,并在迁移完成后执行本地知识库应用的索引构建。在闪迪奥丁马仕 GX PRO 8100上,100GB文件夹的完整复制仅耗时35秒,平均吞吐超过3.5GB/s。
而在索引构建环节,应用需要密集读取数千个文档文件并写入向量数据库,这是典型的随机混合负载,这块2TB容量版本SSD 高达2.3M/2.4M IOPS的随机读写性能在此发挥了关键作用——使用AnythingLLM将总计247份文档导入工作区并执行向量索引构建,总耗时仅42秒,整个过程进度推进顺滑流畅,没有出现低性能存储产品上常见的"长时间卡在某一份文件"的现象。
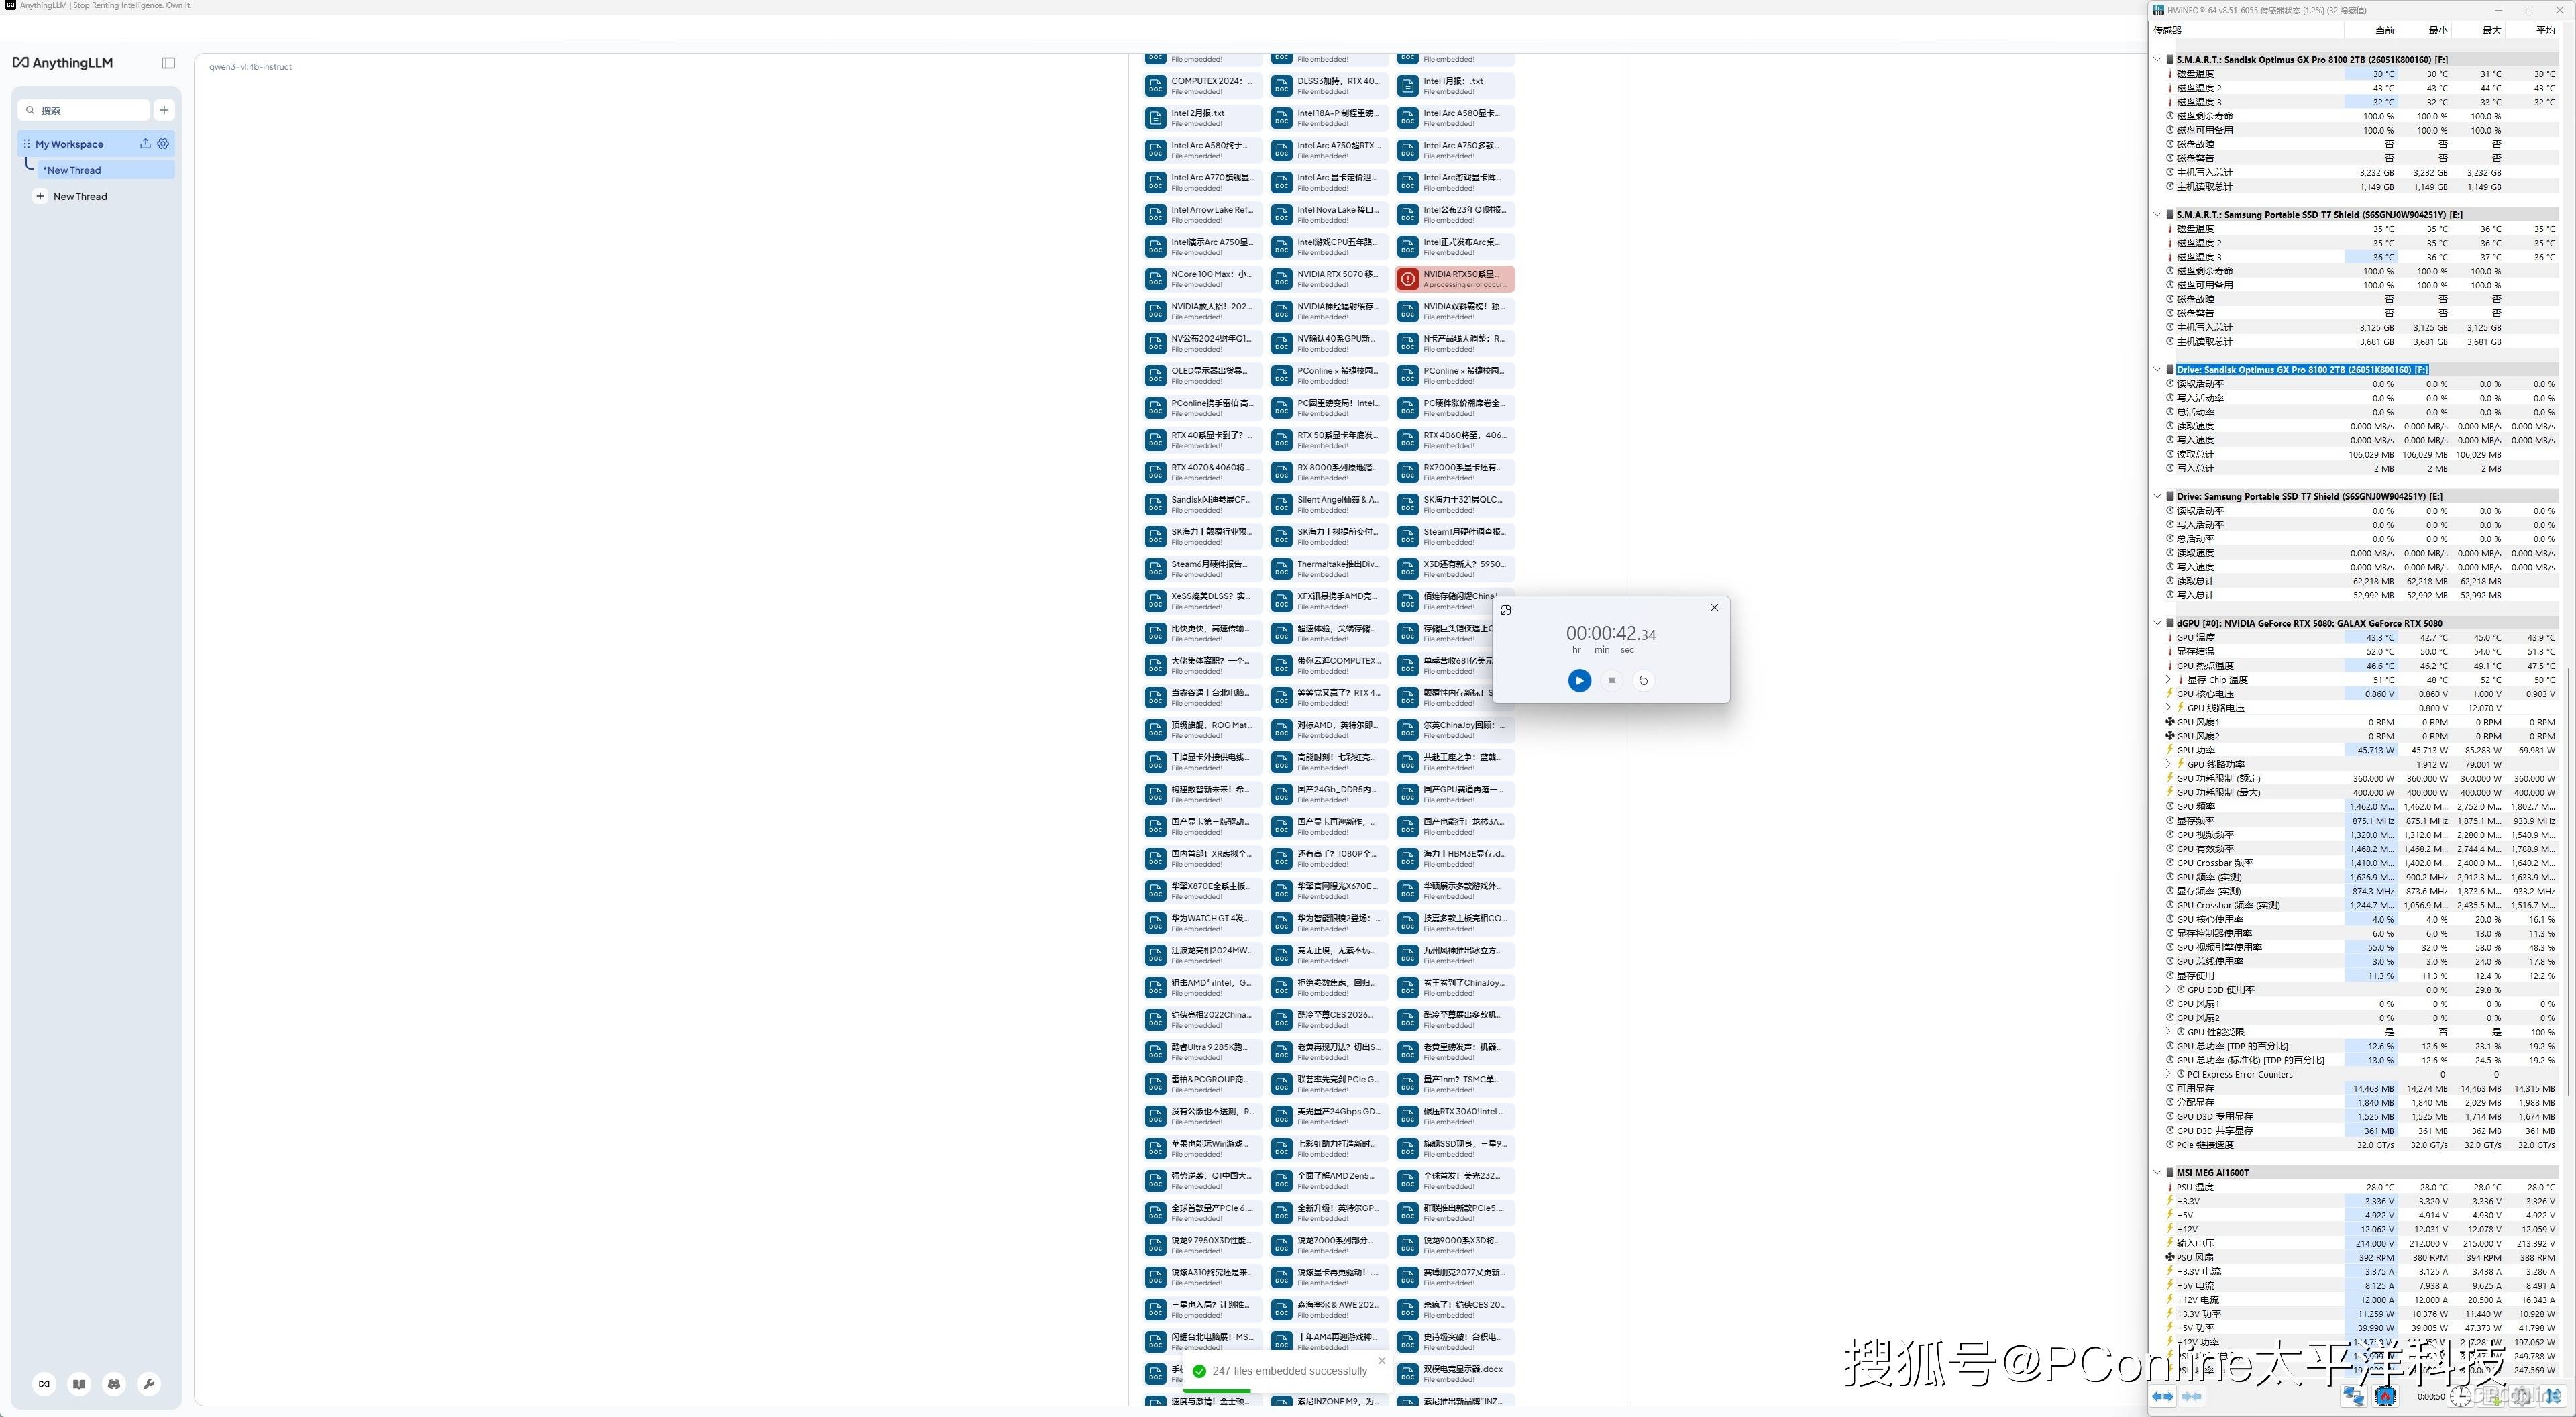
对于需要频繁更新知识库的用户而言,这种效率提升是会随着数据量放大而持续累积的。今天省下的几十秒,在一年数百次的知识库更新中,就是节约了数个小时的等待时间。
实测三:长时间持续负载,稳定性才是AI场景的硬指标
如果说前两项测试考察的是爆发力,那么这一项考察的就是耐力。我们设计了一个贴近真实使用强度的长时负载测试:使用基于Whisper模型的本地语音转写软件Buzz,对总长28小时的音频素材进行连续批量转写,将其全部转换为TXT字幕文件。整个过程中SSD持续处于模型驻留、音频读取与文本写入的混合负载状态。
结果令人印象深刻:28小时的音频总量,全部转写完成仅耗时35分钟,且从第一个文件到最后一个文件,转写速度始终保持一致,没有出现任何可感知的性能衰减。这背后是其在能效上的硬功夫——这款SSD的平均运行功耗可控制在7.5W或更低,相比上一代PCIe 4.0产品能效提升超过2倍(1TB至4TB容量版本),更低的功耗意味着更少的发热,也就从源头降低了过热降速的概率。测试全程我们通过HWiNFO64监控了SSD温度,在机箱常规风道下,其工作温度始终稳定在31°C至43°C的健康区间,距离降速阈值还有相当大的余量。
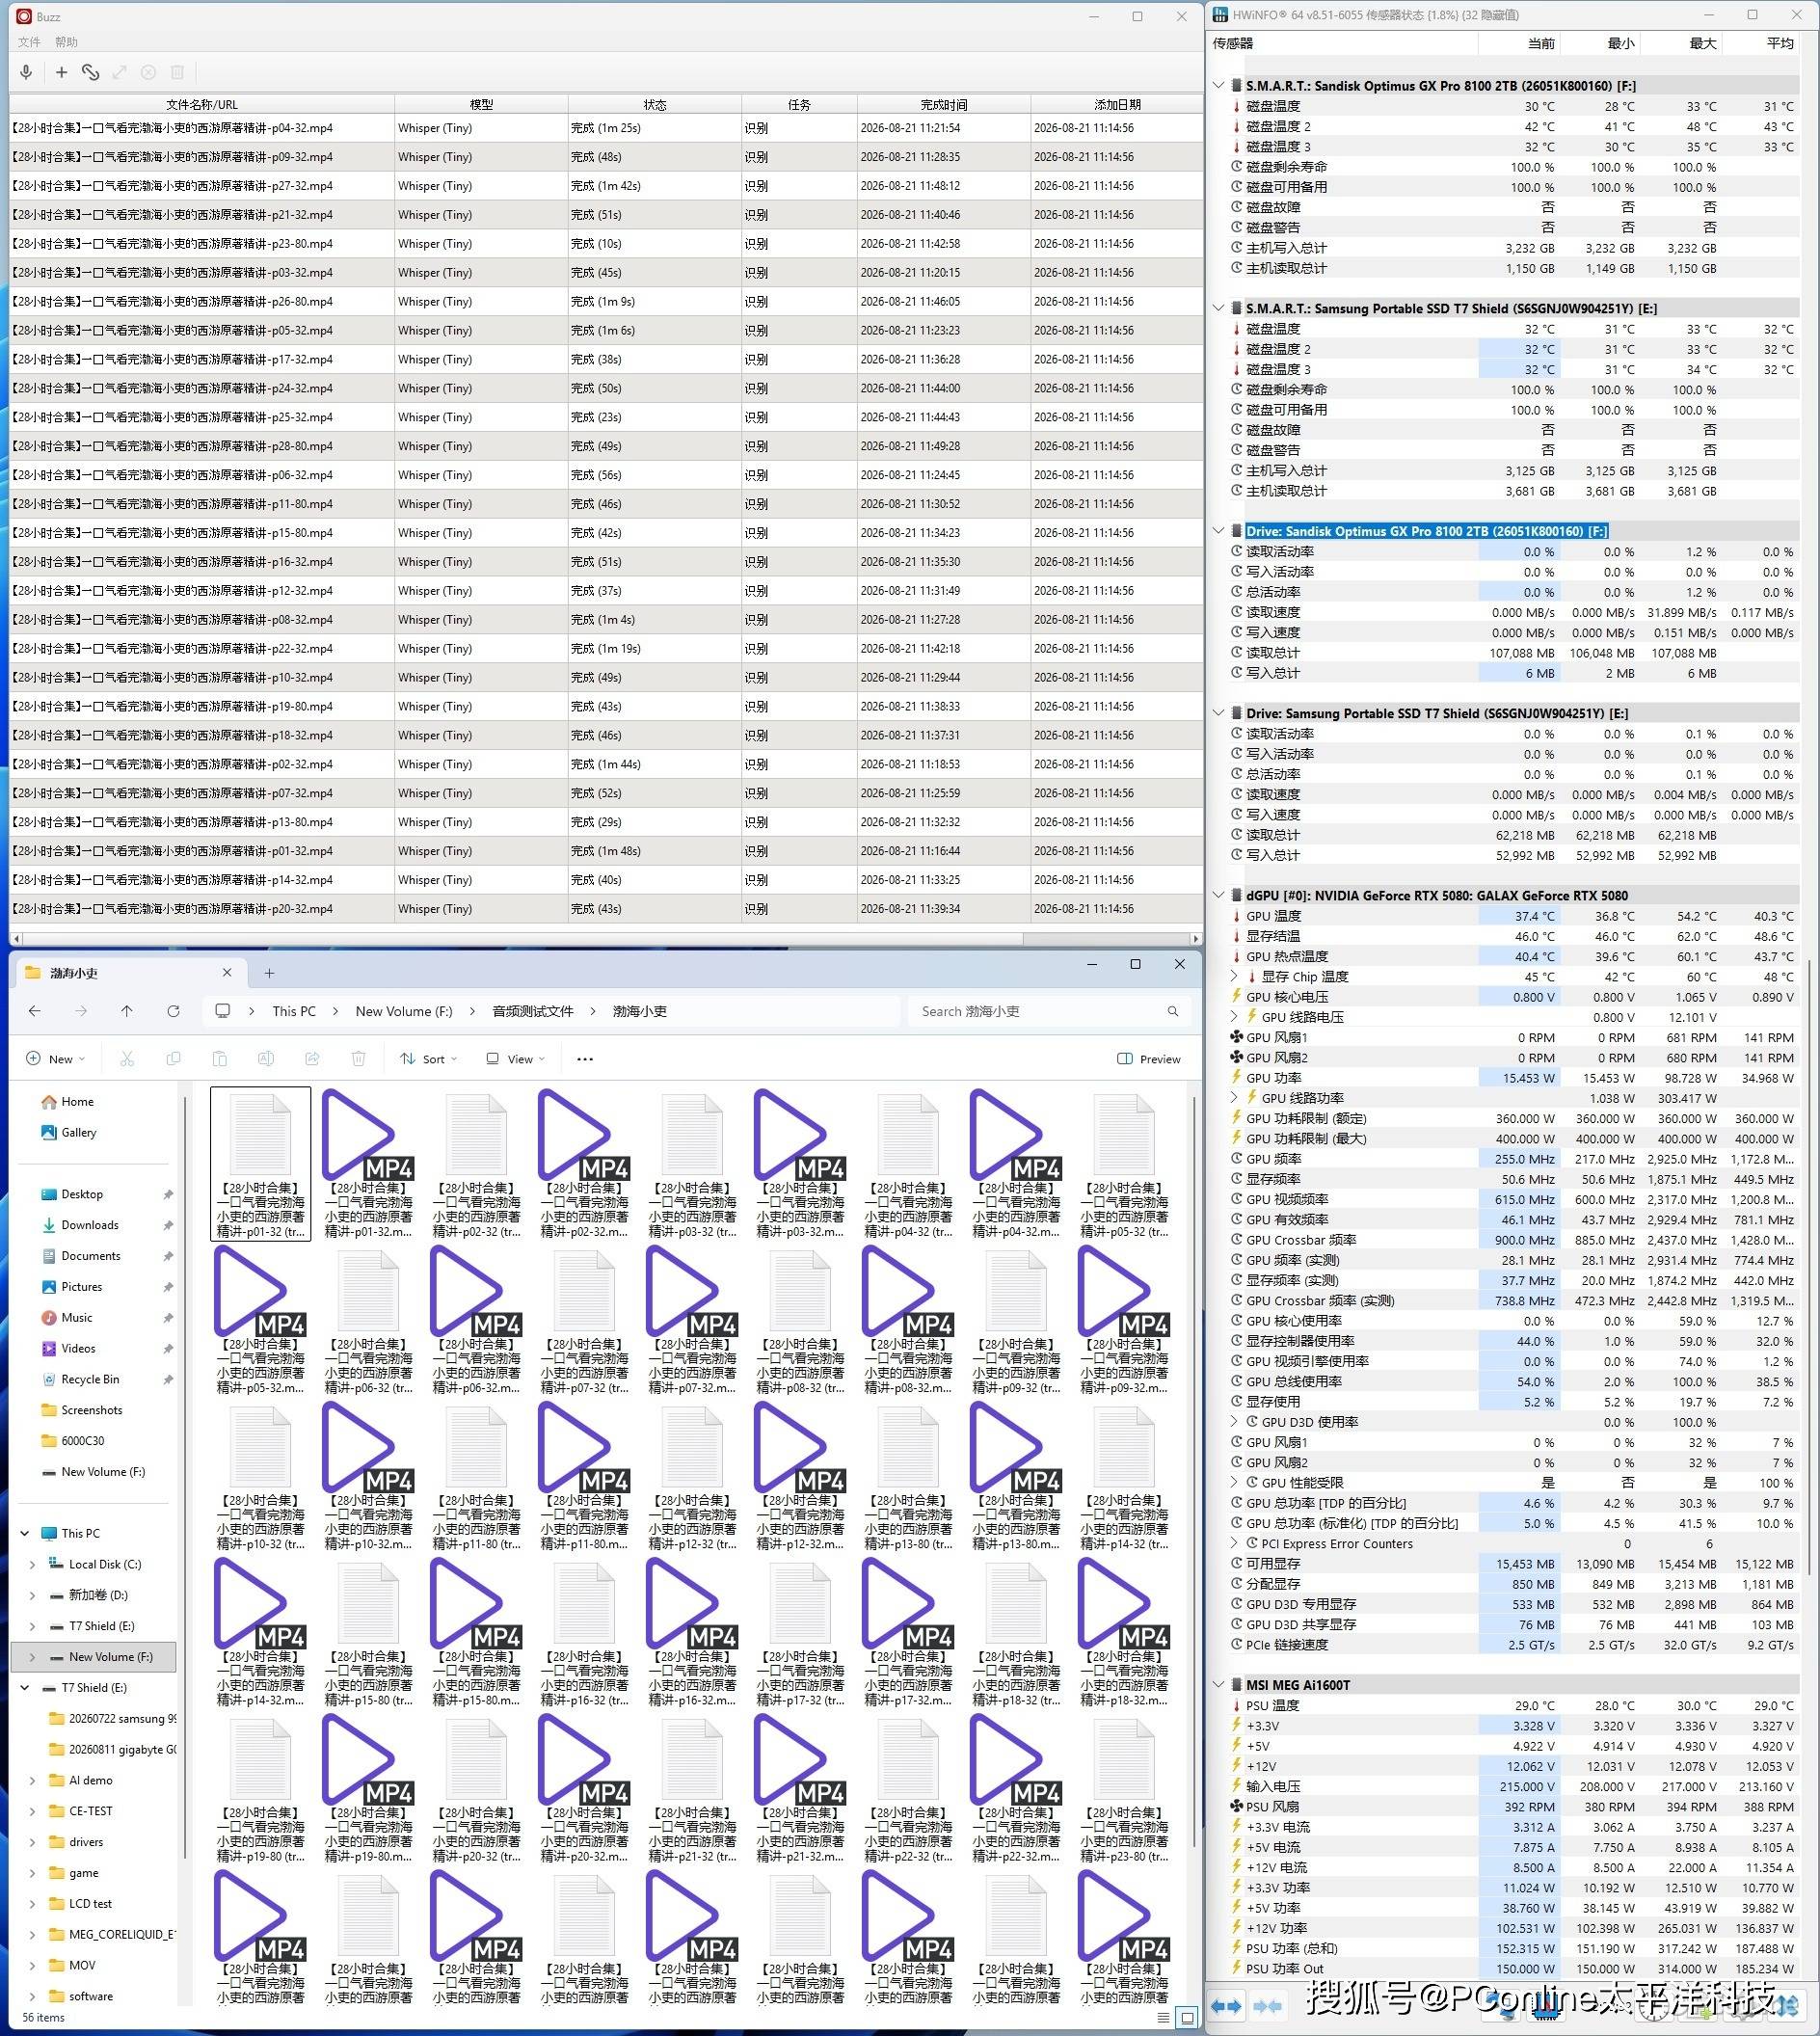
这一点对于AI PC用户尤为重要。本地AI应用的使用模式天然是"挂机式"的——批量转写、批量索引、长时间推理,用户往往把任务挂在那里就去做别的事情。一块在长时间负载下会"掉速"的SSD,会让后半程任务的完成时间不可控地延长;而闪迪奥丁马仕 GX PRO 8100 2TB版本在整个测试过程中展现出的性能一致性非常可观,用户完全可以精确预估任务时间,把AI工作流真正纳入自己的日程管理。
实测四:多任务并行,随机性能决定流畅下限
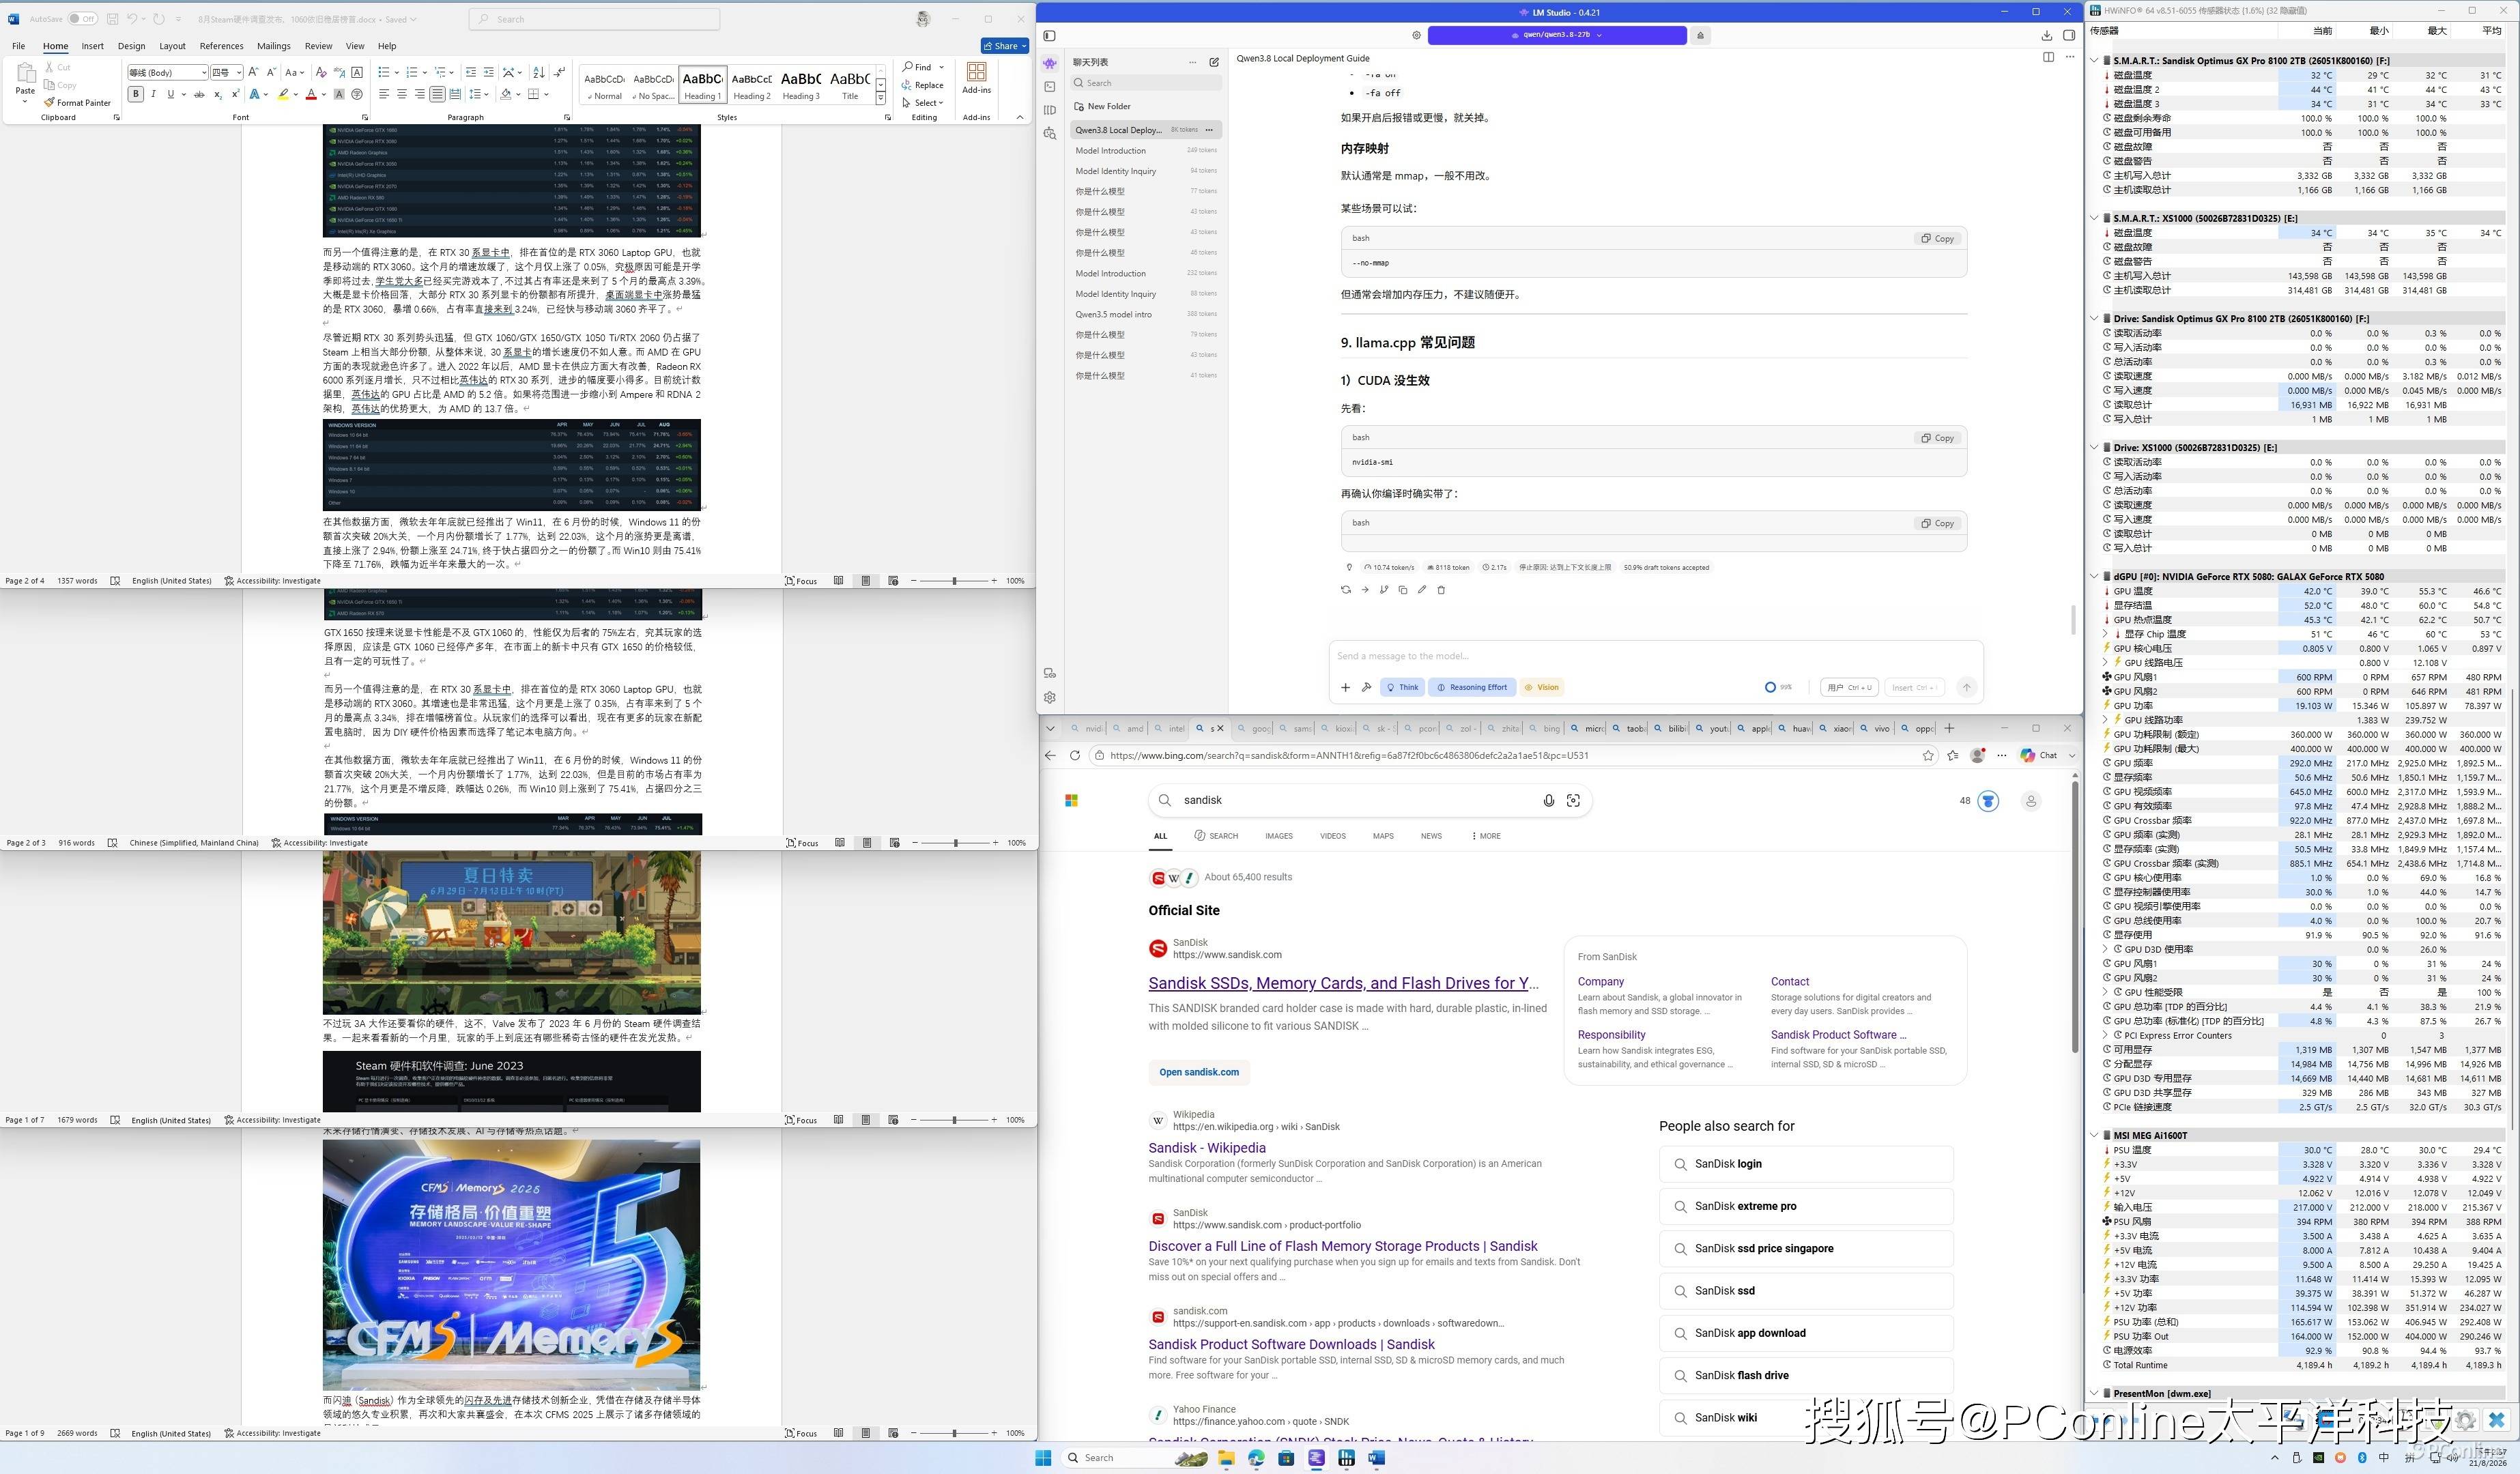
真实的AI PC使用场景,很少是"只跑一个AI"。更常见的状态是:本地大模型在后台回答你整理好的批量问题,前台同时开着浏览器查阅资料、挂着即时通讯软件、编辑文档,甚至还在进行模型文件的下载。这种多任务并行状态下,系统对存储的请求是高度随机且突发密集的。
我们在闪迪奥丁马仕 GX PRO 8100 2TB版本上模拟了这一场景:后台运行Qwen3.8-27B大模型的连续推理输出,同时前台进行文档编辑、多标签页网页浏览与资料检索。实测数据显示,无后台任务时模型输出速度为10.75 tok/s。
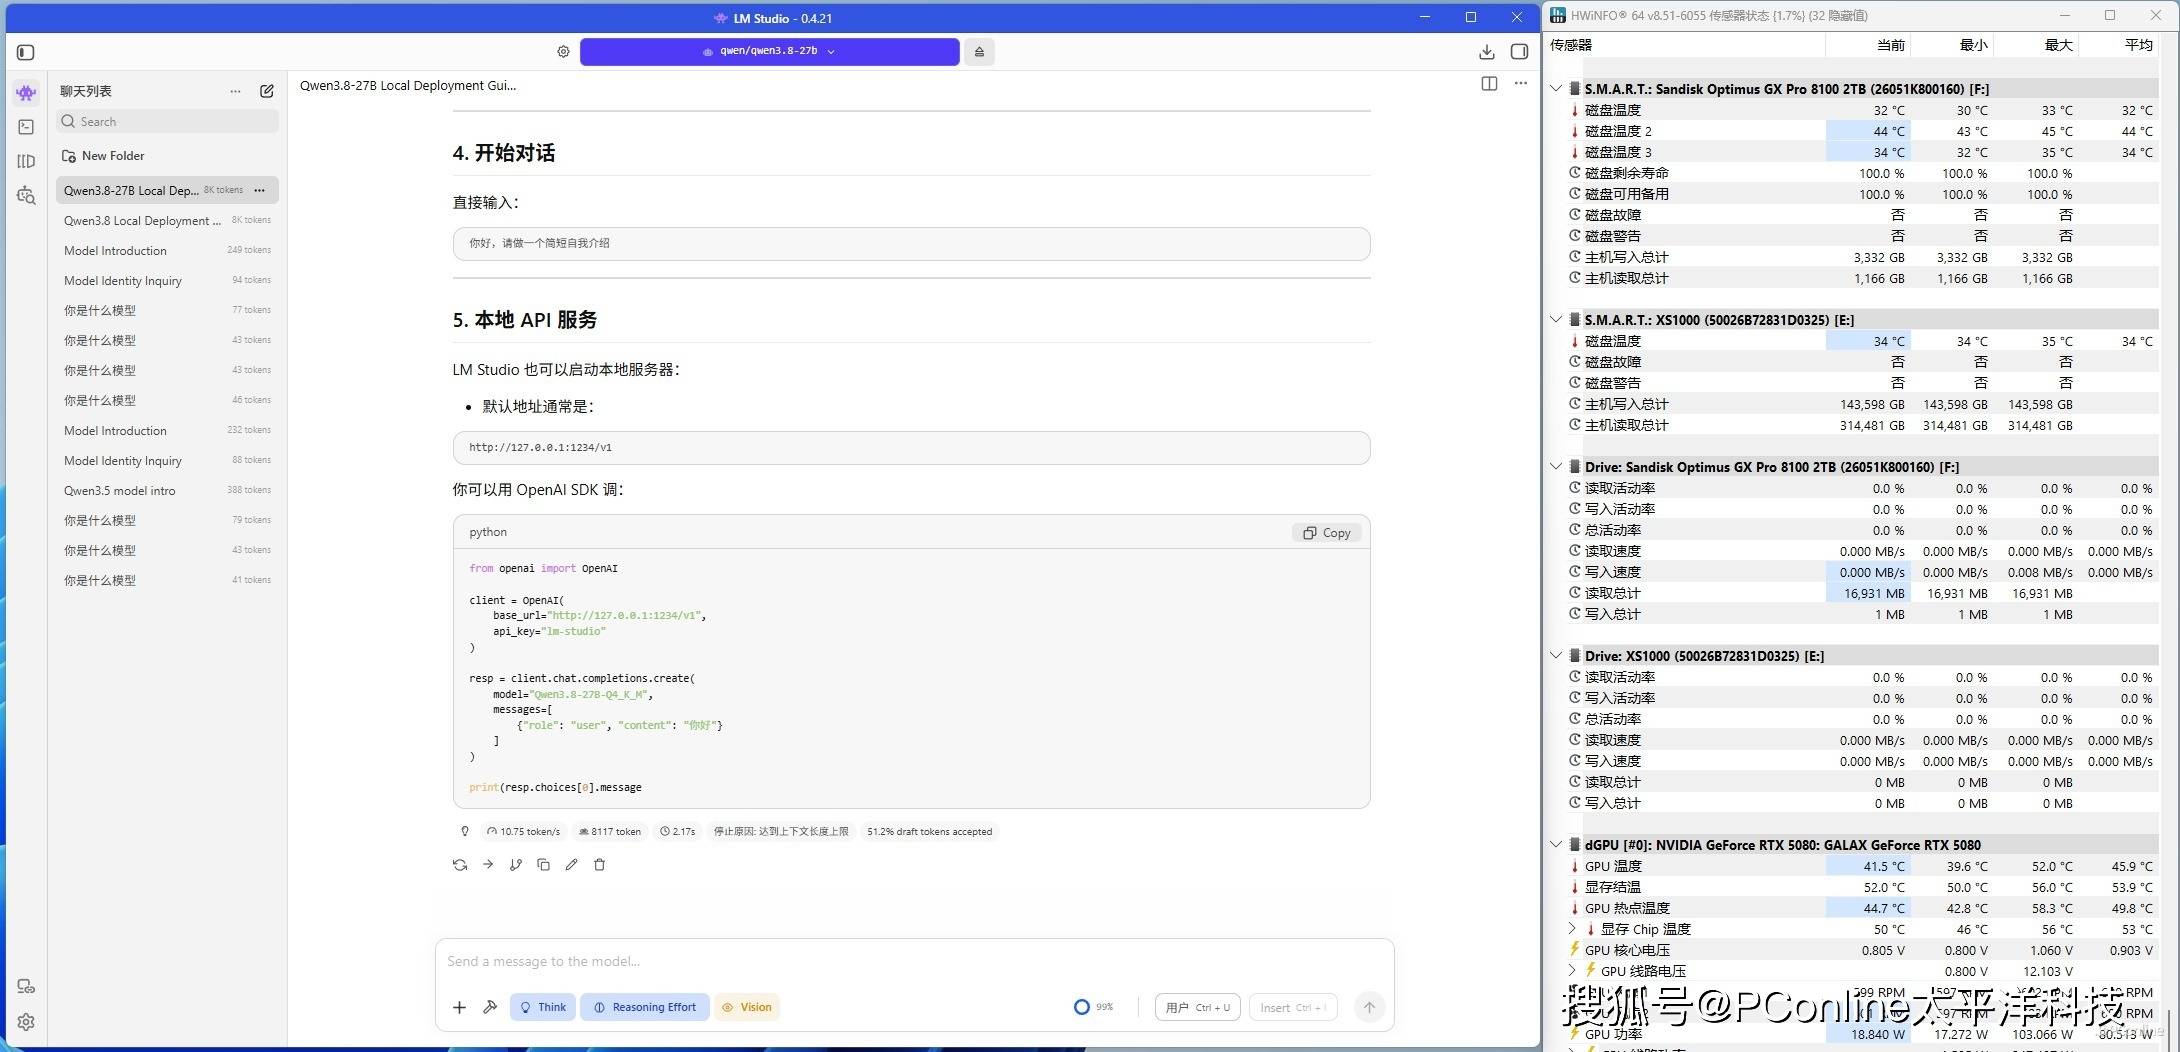
而在多任务并行状态下,输出速度为10.74 tok/s——两者几乎没有差别。整个过程中,系统响应始终保持轻快,前台应用的操作没有任何迟滞。逼近15GB/s的顺序带宽、超高随机性能与独立DRAM缓存的组合,让这块SSD在面对突发混合负载时游刃有余——DRAM缓存保证了地址映射表的快速访问,随机性能则保证了碎片化请求的即时响应,二者共同构筑了多任务场景下的流畅下限。
不同用户,该怎么选?SANDISK Optimus闪迪奥丁马仕系列全满足!
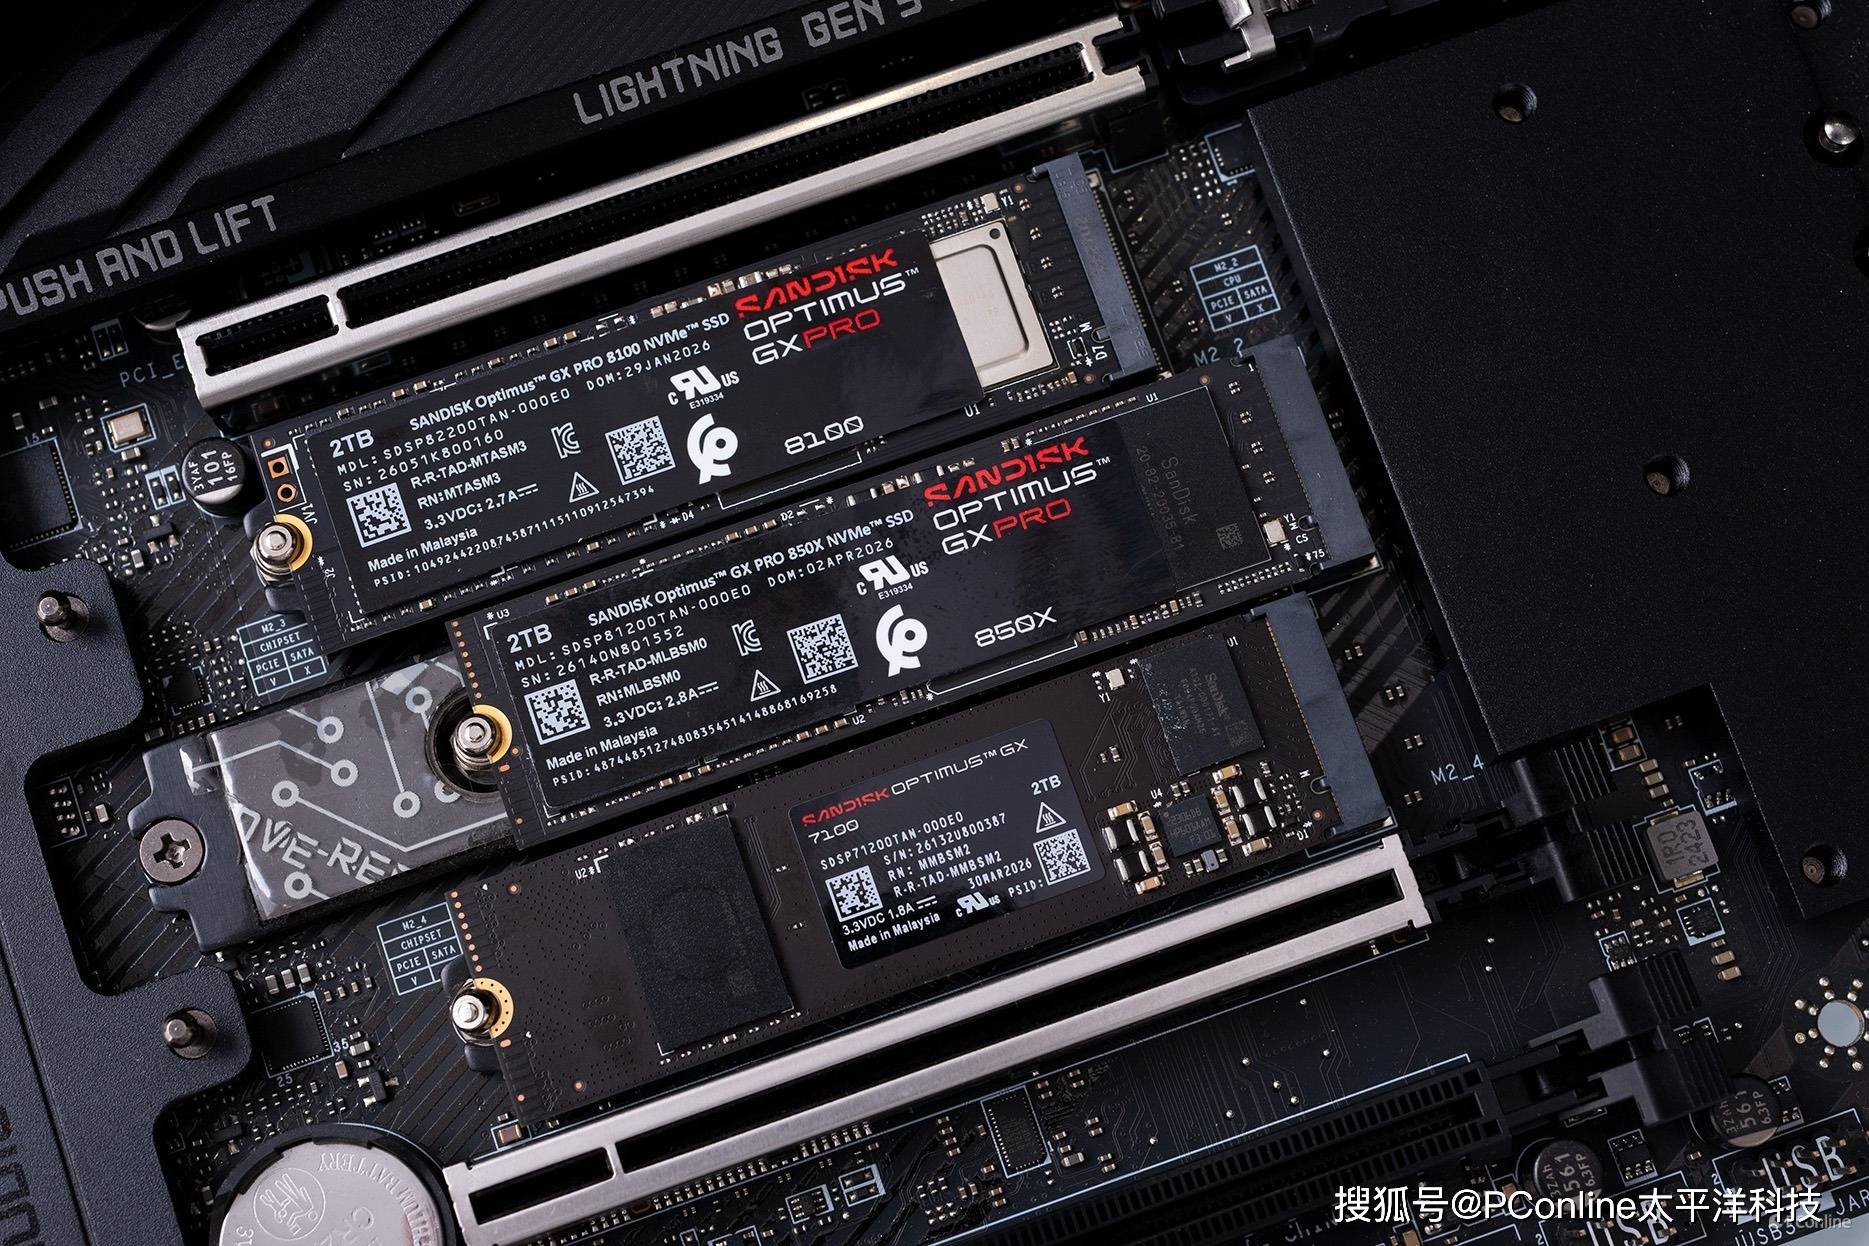
通过本轮实测我们可以确认,本地AI工作负载确实对存储提出了区别于传统应用的新要求,而SANDISK Optimus闪迪奥丁马仕系列不单只有旗舰级的闪迪奥丁马仕GX PRO 8100,它还有不同定位的产品能够覆盖了从旗舰到主流的完整需求。
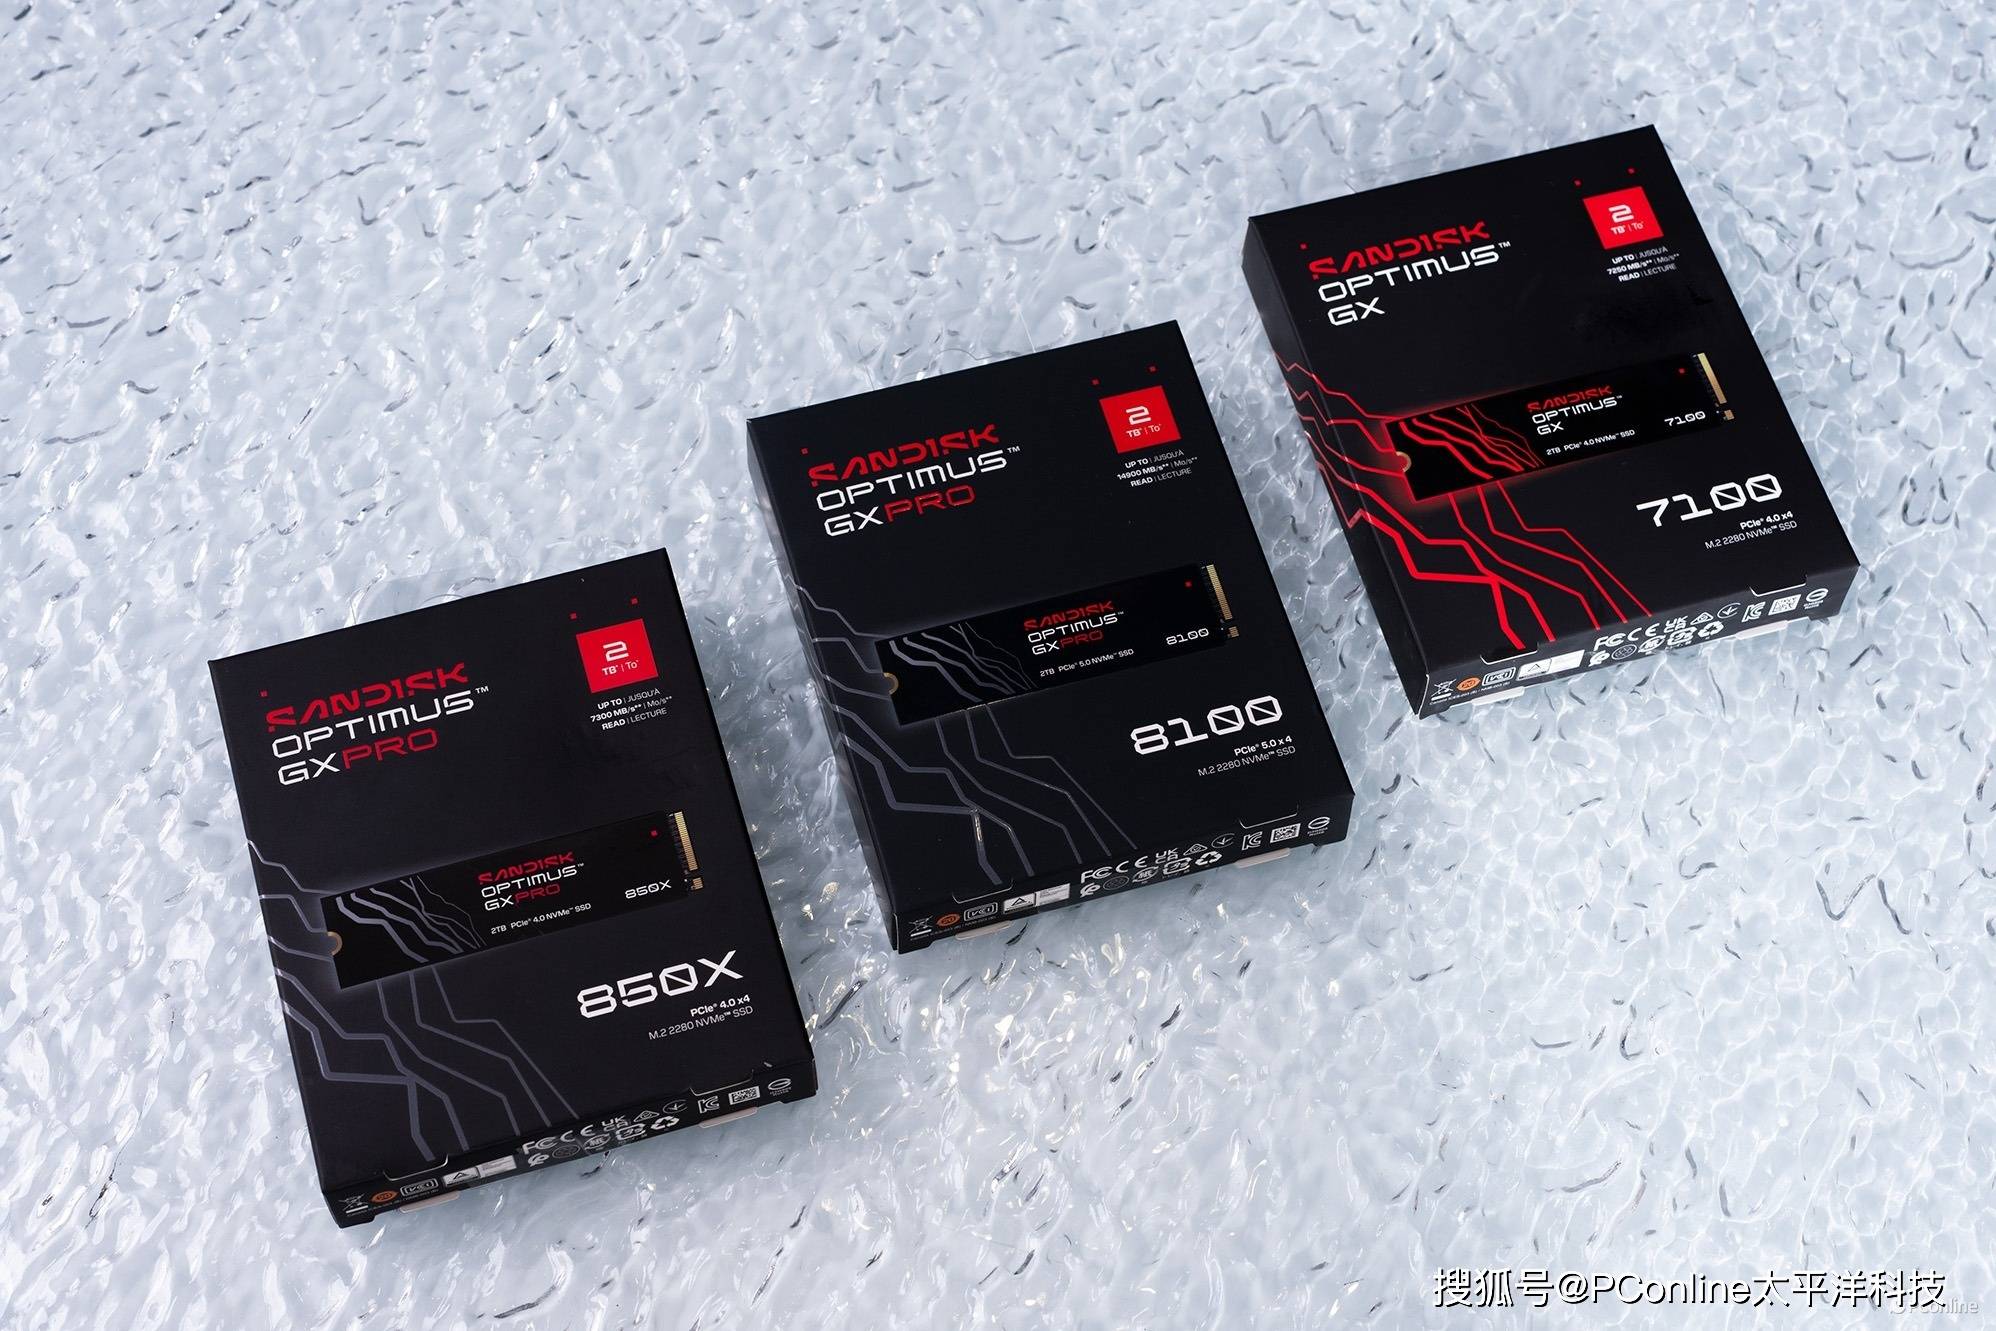
如果你是重度本地AI用户——会部署多个大参数模型、频繁进行知识库构建与批量数据处理、把本地AI当作日常生产力工具,那么闪迪奥丁马仕 GX PRO 8100是不二之选。PCIe 5.0接口带来的高达14,900MB/s顺序读取速度让模型加载与数据流转快如闪电,2.3M/2.4M IOPS的随机性能(2TB至4TB容量版本)保证推理与多任务场景的流畅,2倍的能效提升(1TB至4TB容量版本)与低至7.5W的平均功耗确保长时间AI任务的性能一致性。当然,它同样适合对加载速度有极致要求的硬核游戏玩家。对于搭建AI PC、高性能工作站或旗舰游戏主机的用户而言,这就是当前消费级存储的性能天花板。
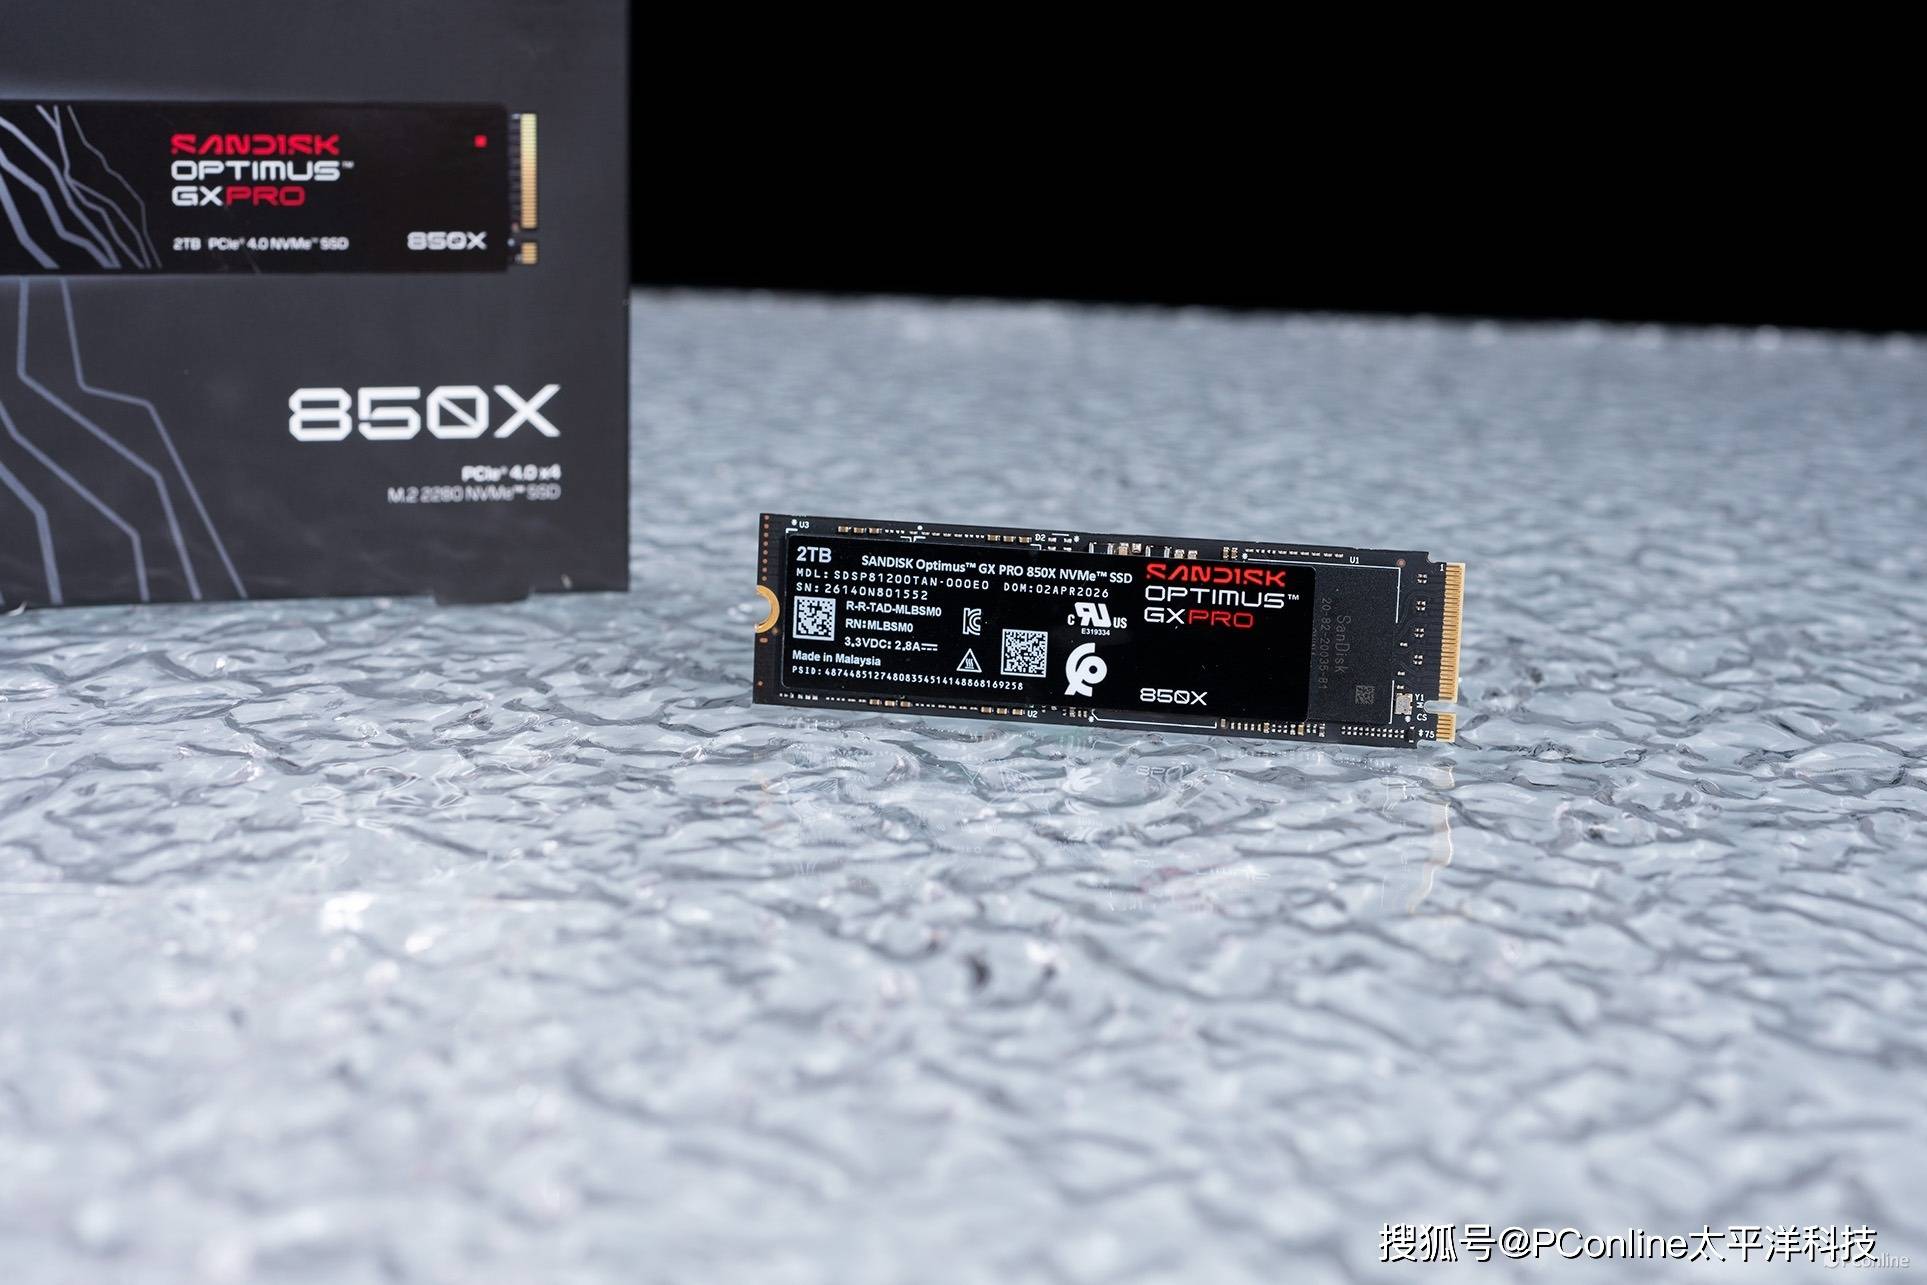
如果你的平台暂不支持PCIe 5.0,但仍希望获得旗舰级的稳定体验,闪迪奥丁马仕GX PRO 850X NVMe SSD是PCIe 4.0阵营的标杆答案。高达7,300/6,600MB/s的顺序读写速度与高达1.2M/1.1M IOPS的随机性能(2TB至4TB容量版本),应对中小规模本地模型的加载与推理毫无压力。
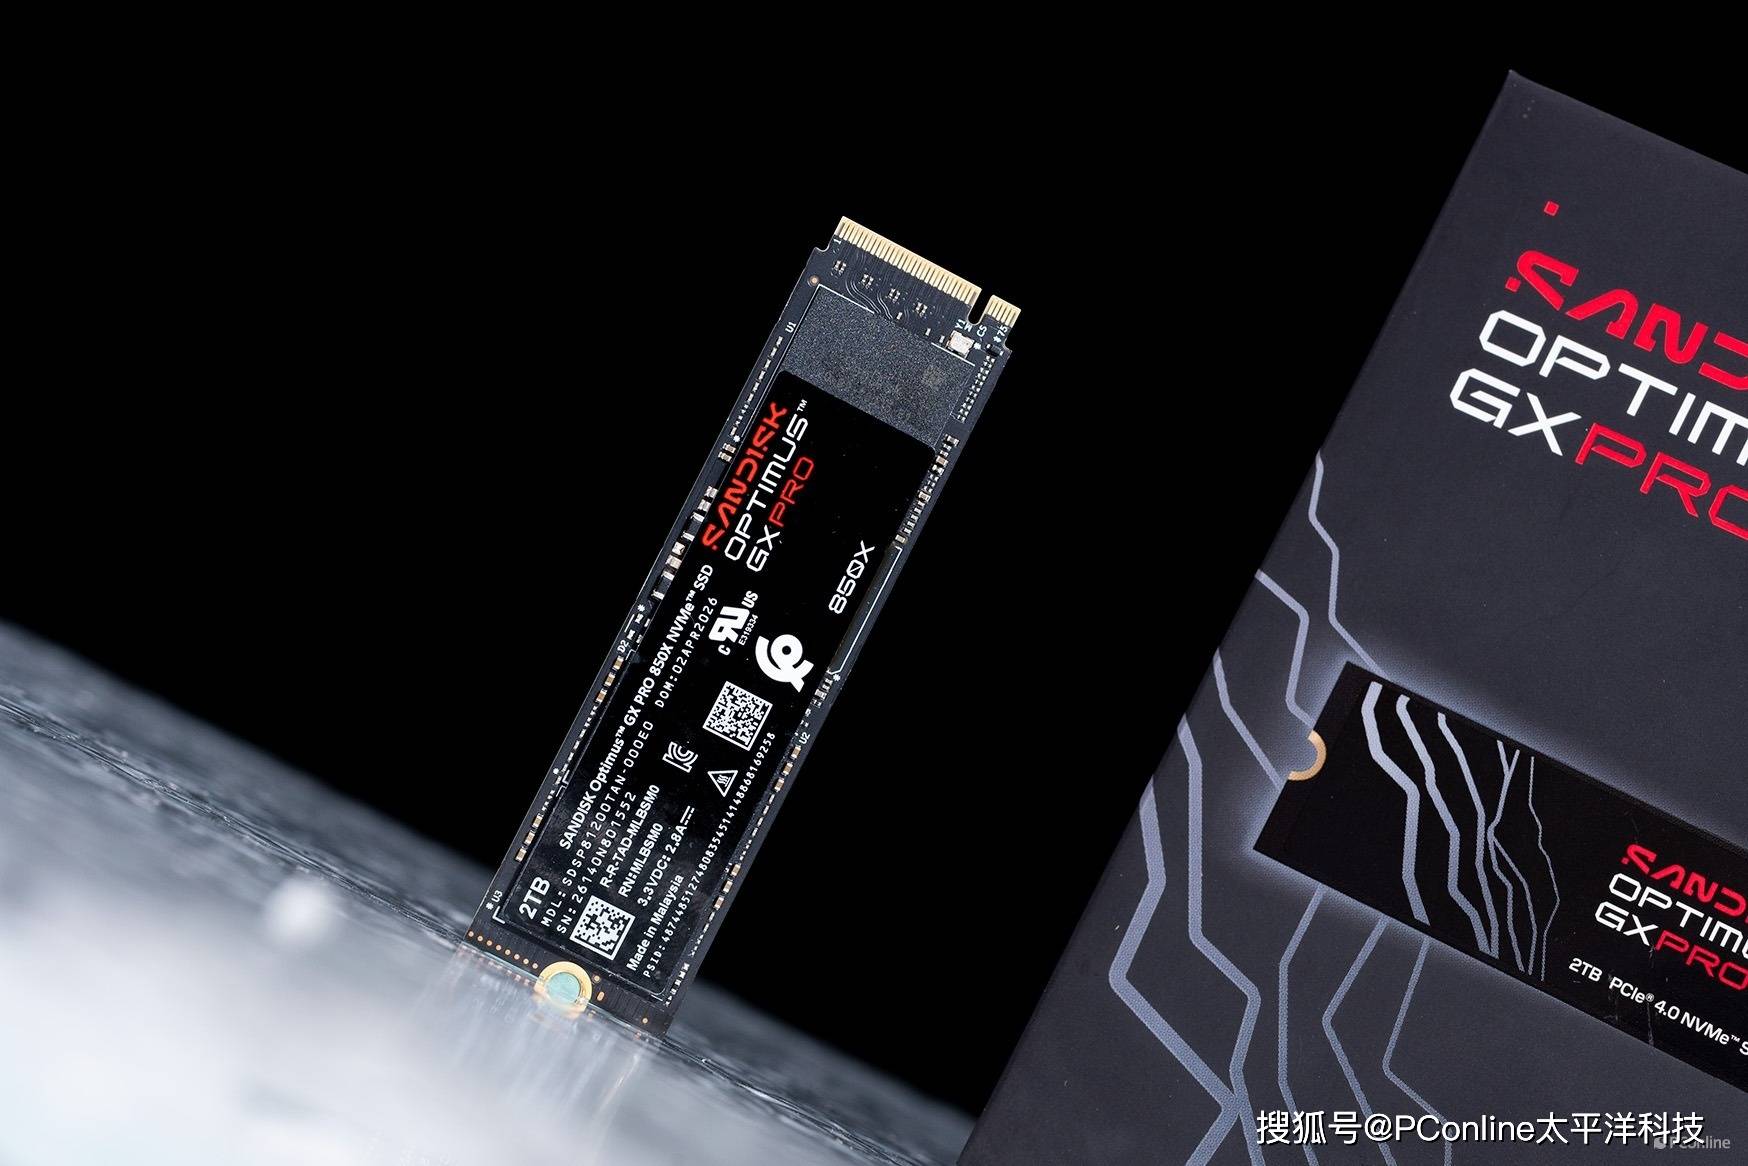
闪迪奥丁马仕GX PRO 850X NVMe SSD搭载独立DRAM缓存与SANDISK nCache 4.0技术,多任务场景表现稳健;拥有丰富可选容量版本、以手上2TB版本为例其拥有高达1,200TBW耐久度与5年有限质保的规格,与旗舰师兄看齐。
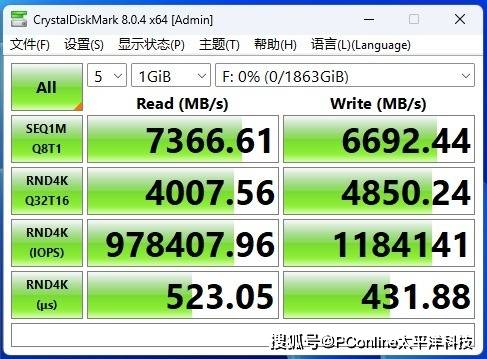
我们也对其2TB版本进行了实测:CrystalDiskMark顺序读取速度高达7,367MB/s、顺序写入速度高达6,692MB/s,随机读取约97.8万IOPS、随机写入约118.4万IOPS;
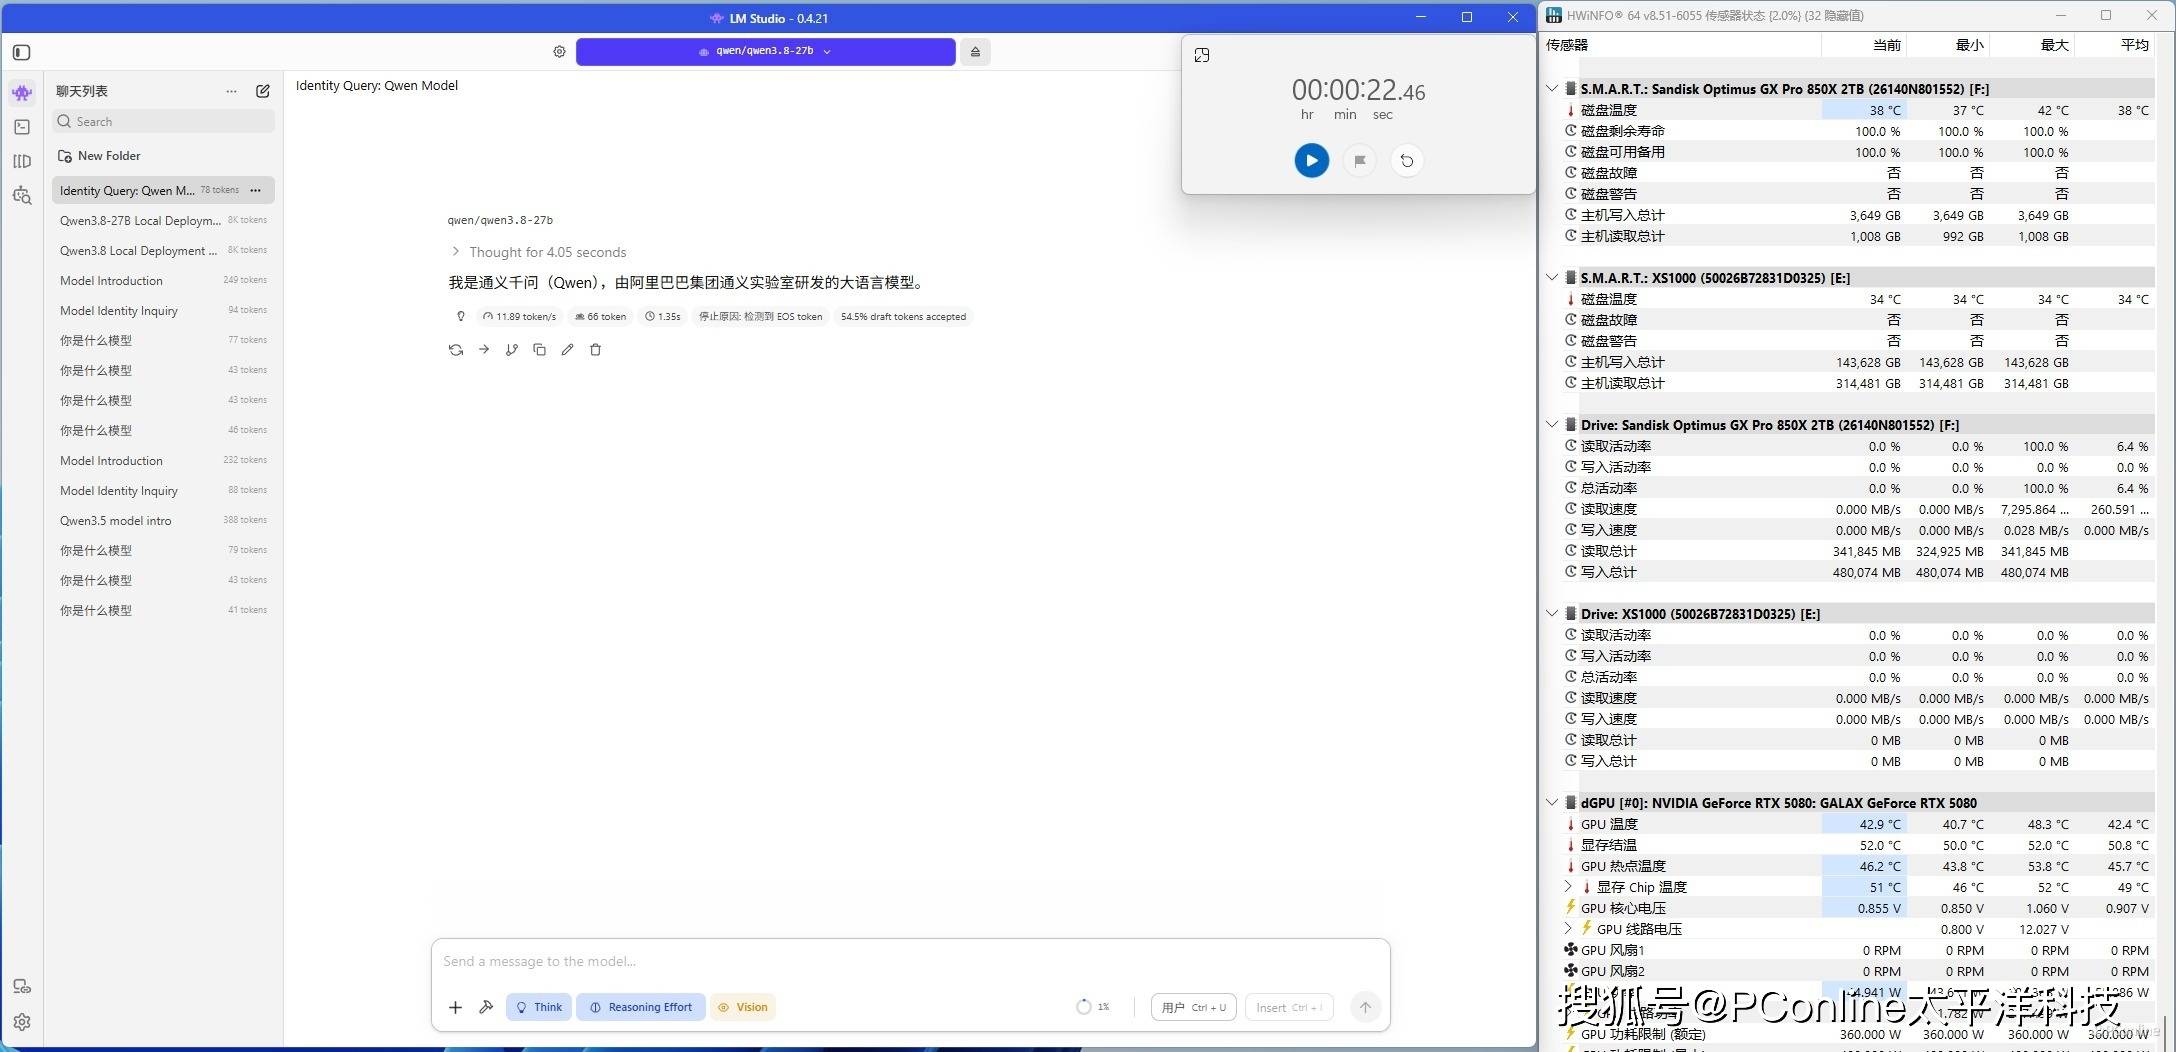
在Qwen3.8-27B模型加载测试中耗时约22.46秒,应对中小规模本地模型的加载与推理没有压力。对于主流台式机用户、兼顾游戏与日常AI应用的学生群体与职场人士,它就是绝佳之选。
如果你的主战场是游戏本、轻薄本或掌上游戏设备,希望以更低的功耗获得轻快体验,闪迪奥丁马仕GX 7100 NVMe SSD则是高能效路线的代表。
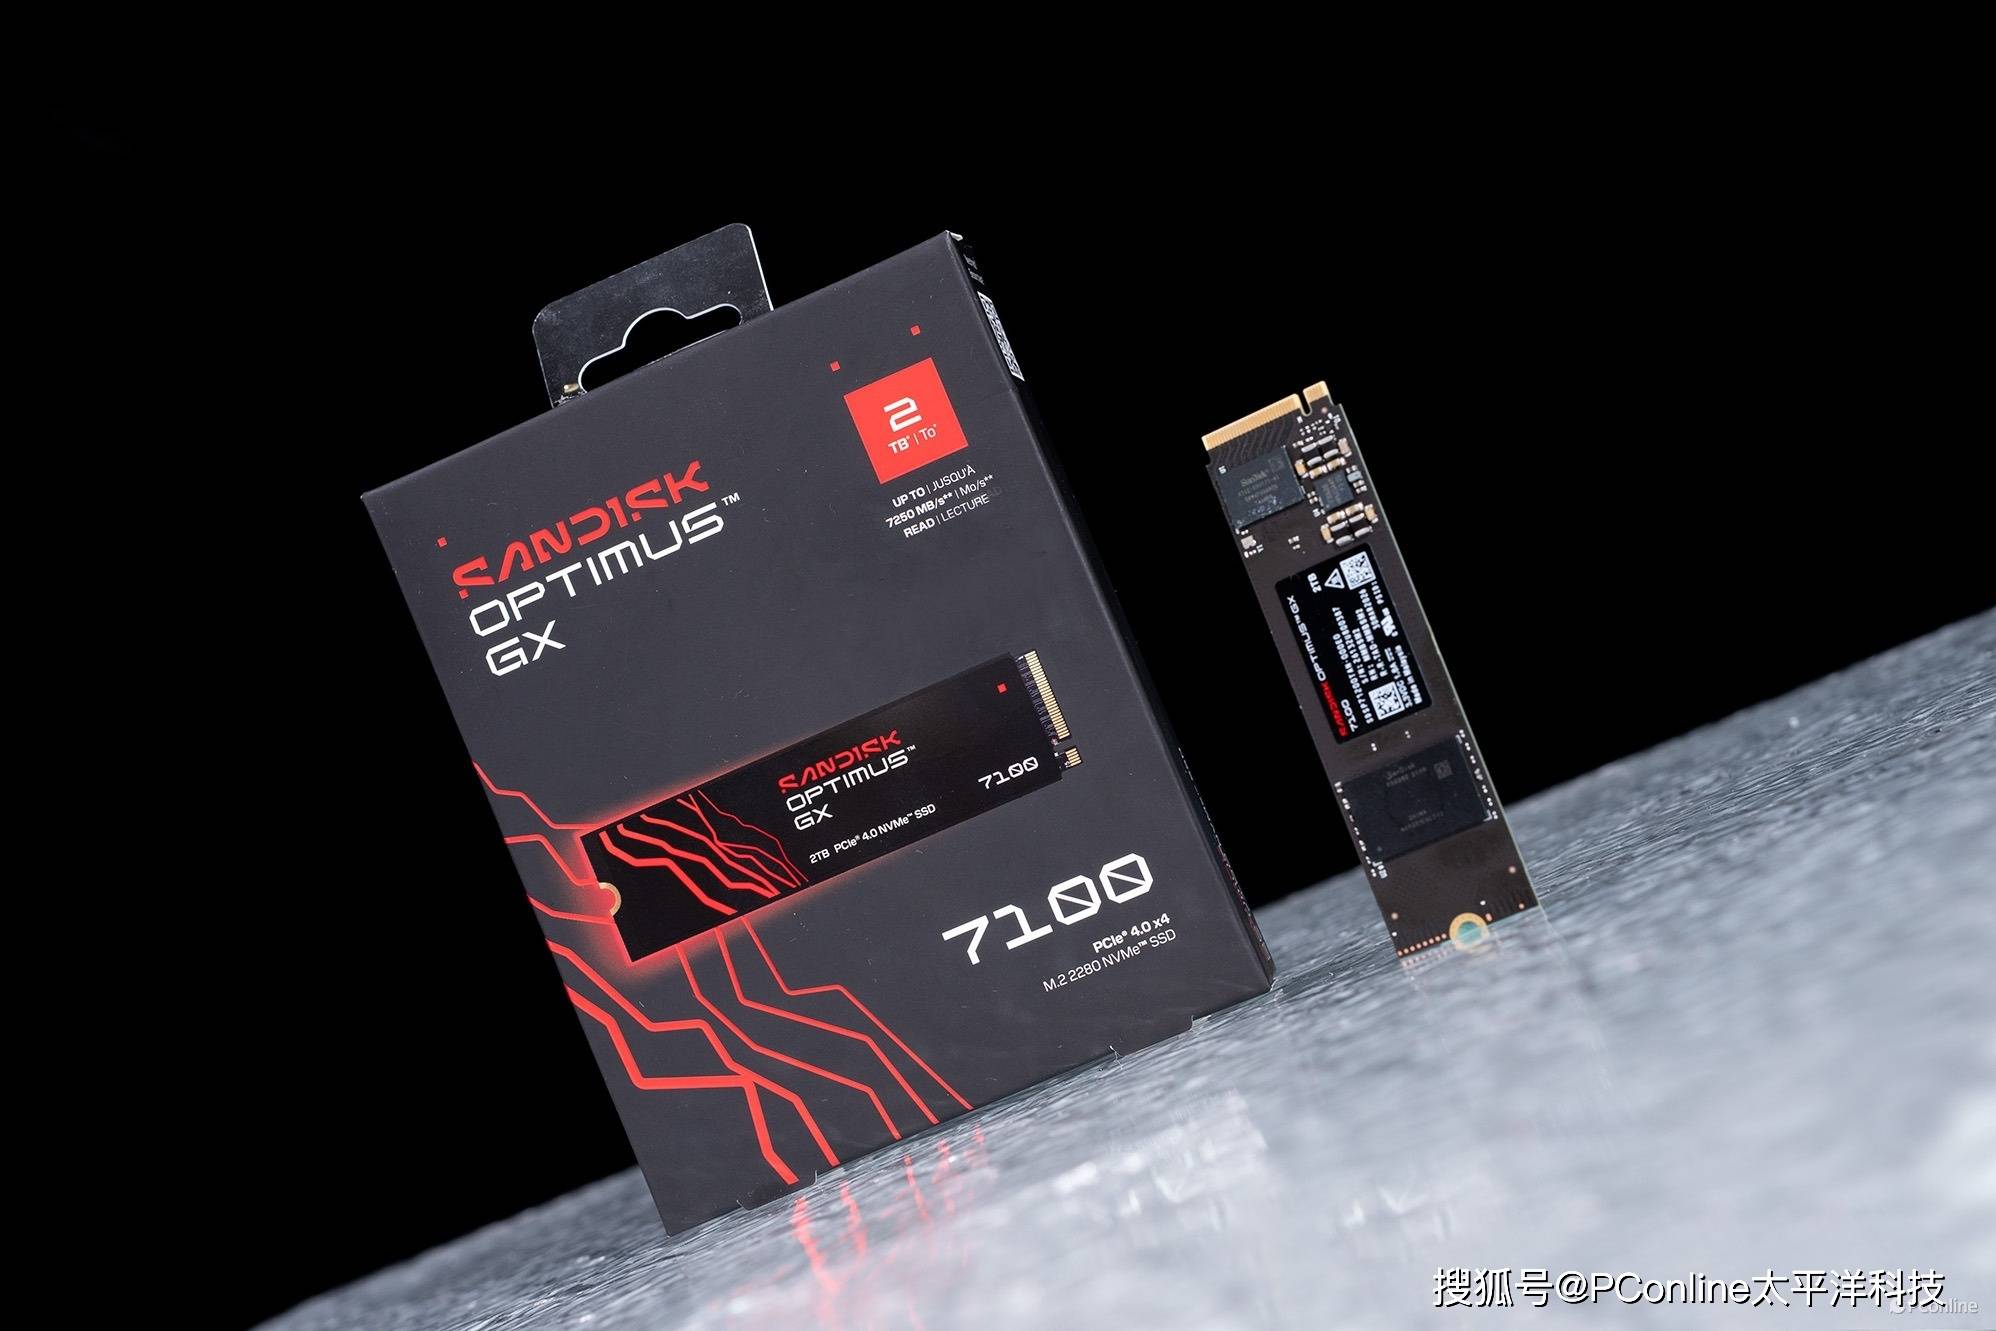
它采用DRAM-less设计,顺序读取速度高达7,250MB/s、顺序写入速度高达6,900MB/s(1TB与2TB容量版本),随机读写高达1M/1.4M IOPS(1TB至2TB容量版本),性能足以流畅运行7B至14B级别的本地模型;
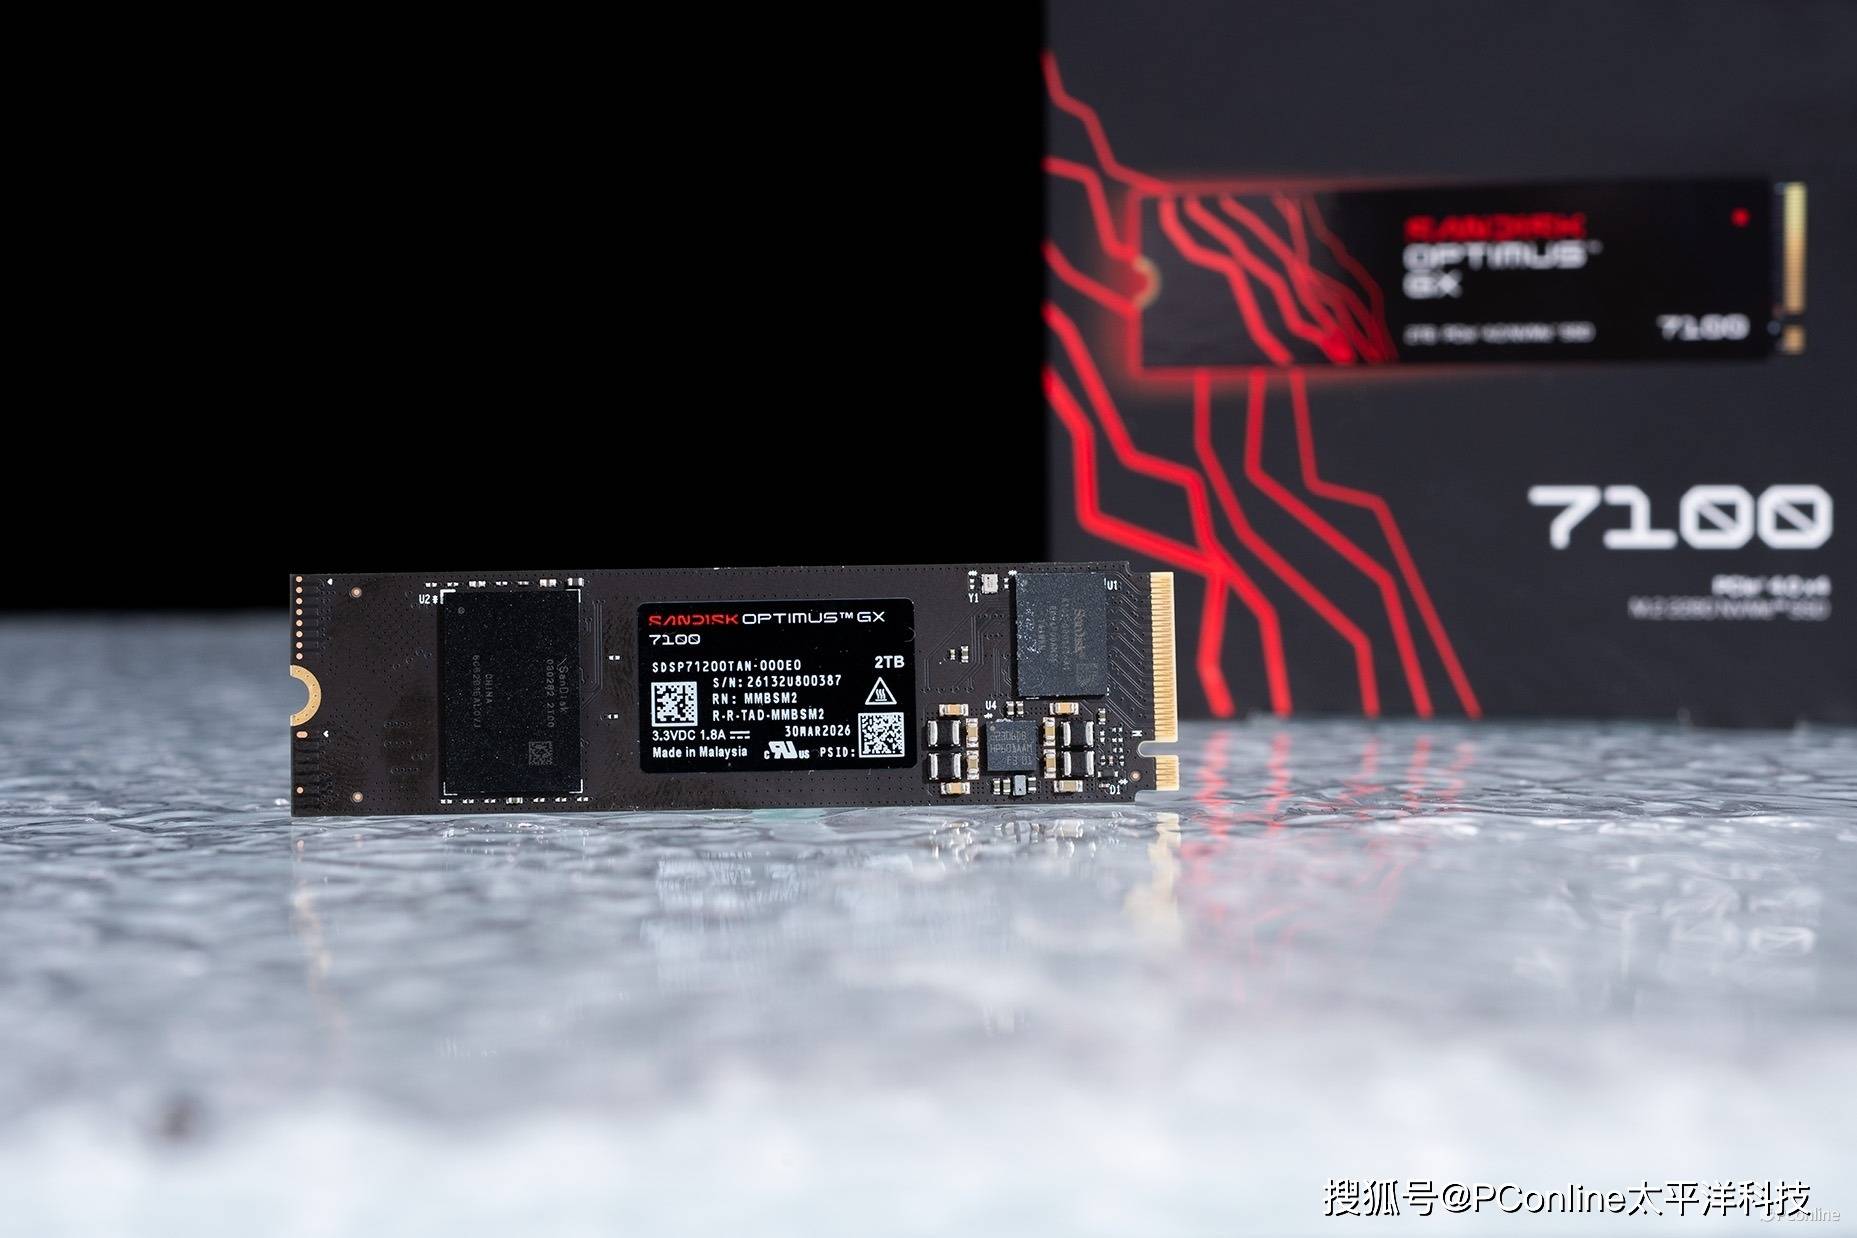
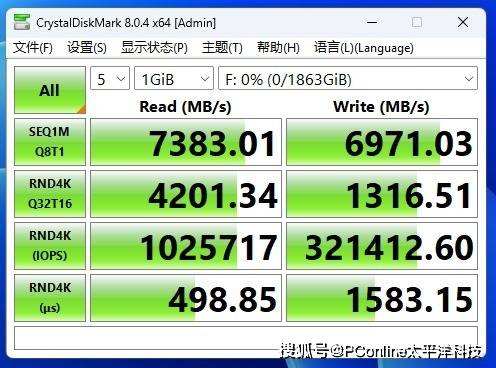
其真正的杀手锏在于能效——平均读写功耗仅3.4W至4.1W,对笔记本的续航与散热都极为友好,即使在移动场景下也能从容运行各类应用。实测中,其2TB版本CrystalDiskMark顺序读取速度高达7,383MB/s、顺序写入速度高达6,971MB/s,随机读取超过102万IOPS;
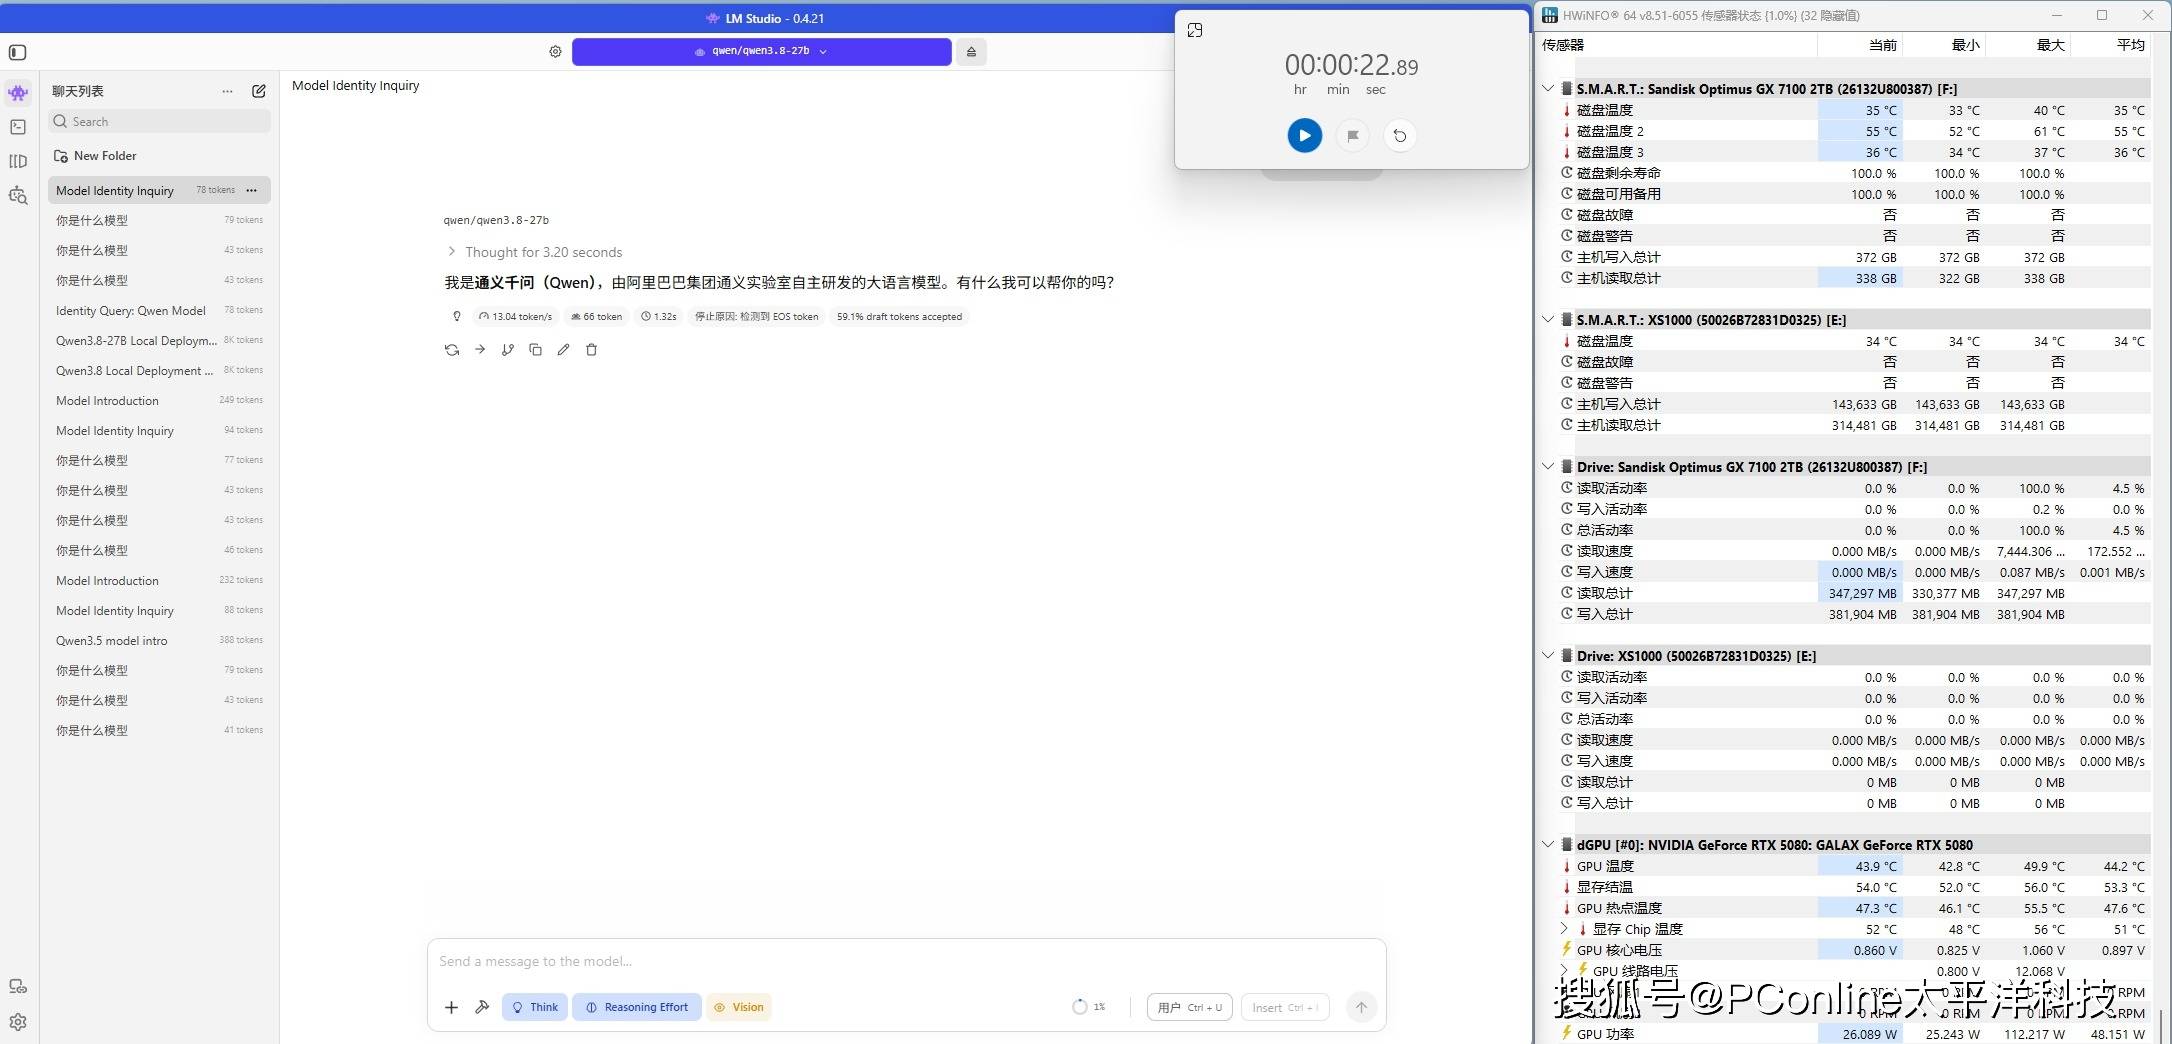
Qwen3.8-27B模型加载耗时约22.89秒,流畅运行中小参数本地模型不成问题。提供高达4TB的容量、1,200TBW的耐久度(2TB容量版本)与5年有限质保,让它成为宿舍装机、笔记本扩容与掌机升级场景下的不二之选。
对于本地AI的入门体验者、轻量级知识库用户,或是希望在一台PC上同时兼顾日常游戏与偶尔的本地模型尝鲜的人群而言,SANDISK Optimus闪迪奥丁马仕系列同样提供了适配其需求的存储方案——闪迪奥丁马仕 5100 NVMe SSD。这款SSD 采用PCIe 4.0 x4 NVMe接口,搭载新一代SANDISK BiCS8 3D NAND闪存技术,在1TB至2TB容量版本上可提供高达7,100 MB/s的顺序读取速度,同时拥有高达4TB的容量选项。该产品同样搭载SANDISK nCache 4.0技术,在大文件传输与突发写入场景下能够有效提升响应效率,并享有5年有限质保,延续了闪迪一贯的品质承诺。
写在最后:AI PC时代,存储不再是配角
当AI真正住进电脑里,PC的每一个硬件环节都在被重新定义。过去我们评价一块SSD,看的更多是其游戏加载快不快、系统启动快不快;而在本地AI时代,存储设备需要同时扮演模型的高速通道、数据的中转枢纽与长时间负载的稳定基石三重角色。容量决定你能装下多少模型,顺序性能决定你要等多久,随机性能决定体验流不流畅,能效与耐久决定这套体验能稳定运行多少年。
AI从云端走向本地的进程才刚刚开始,模型会越来越大,应用会越来越重,工作负载会越来越持续。在这样的趋势下,为PC选择一块不拖后腿的固态硬盘,或许是你为自己的AI体验所做的最划算的一笔投资。而SANDISK Optimus闪迪奥丁马仕系列已经做好了准备,无论你的平台与AI环境如何,都能从中找到匹配自己需求的那一块。


热门商城
更多
热门优惠券
更多-
- ROTHSCROOSTER旗舰店满49减16
- 有效期至: 2025-01-25
- 立即领取
-
- 萨布森旗舰店满1299减800
- 有效期至: 2025-01-17
- 立即领取
-
- 哲高玩具旗舰店满69减33
- 有效期至: 2025-01-05
- 立即领取
-
- 戴·可·思官方旗舰店满196减27
- 有效期至: 2025-04-01
- 立即领取
-
- 佳婴旗舰店满30减3
- 有效期至: 2025-01-10
- 立即领取
-
- ROTHSCROOSTER旗舰店满19减8
- 有效期至: 2025-01-25
- 立即领取
-
- 荣业官方旗舰店满20减10
- 有效期至: 2025-01-04
- 立即领取
-
- 戴·可·思(Dexter)母婴京东自营旗舰店满48减10
- 有效期至: 2025-01-12
- 立即领取
-
- KOKOROCARE旗舰店满158减100
- 有效期至: 2025-03-28
- 立即领取
-
- RODEL官方旗舰店满59减30
- 有效期至: 2025-01-02
- 立即领取