AMD Zen7+RDNA5组合用到2031年:大核显锐龙APU暴力提升
类别:电脑数码
发布时间:2026-11-07 00:55
11月6日消息,前几天网上泄露了AMD未来的Zen7产品线Grimlock,搭配的核显还是RDNA5架构,只是会继续优化,2029年问世,一直用到2031年。
当前的锐龙APU产品线还是Zen5+RNDNA3.5组合,今年到2028年会有Zen6+RDNA5的组合替代,不过中低端的Medusa Point还会是RDNA 4m架构GPU,8组CU单元,搭配128bit LPDDR5X内存。
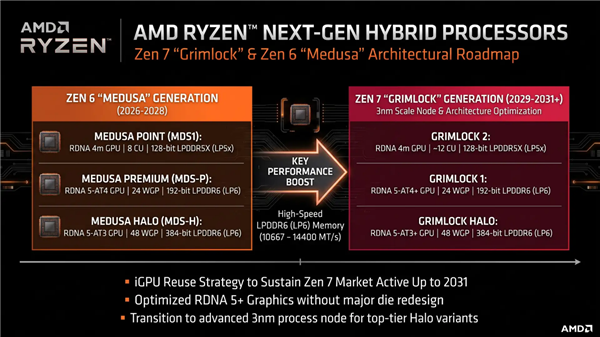
Zen7时代的Grimlock也会分为三个级别,中低端的Grimlock2保持RDNA 4m GPU及128bit LPDDR5X的组合,高端的Grimlock1系列则是RAND5架构的AT4级GPU,24组WGP,也就是48组CU单元,升级到192bit-LPDDR6内存。
旗舰级的Grimlock Halo规格提升就更猛了,RDNA5 AT3级别的GPU核显,48组WGP,也就是96组CU单元,内存升级到384bit LPDDR6。
这样的组合搭配10667-14400MT/s的内存频率,那么内存带宽将达到512GB-691GB/s,要知道当前Zen5架构的Strix Halo也就是256-273GB/s的带宽,Zen6/Zen7时代带宽至少翻倍,如果是按照频率上限,那691GB/s的带宽接近当前RTX 4080显卡的带宽。
那时候要是能搭配上256GB内存容量,再配合96组CU单元的核显、691GB/s的带宽,如此炸裂的性能不知道能把本地AI玩出什么新花样了,几年后的小尺寸AI模型如果优化的够好,那真的是本地Token自由,而且性能会很能打,写代码、跑长程任务都不用顾忌API费用了。




热门商城
更多
热门优惠券
更多-
- ROTHSCROOSTER旗舰店满49减16
- 有效期至: 2025-01-25
- 立即领取
-
- 萨布森旗舰店满1299减800
- 有效期至: 2025-01-17
- 立即领取
-
- 哲高玩具旗舰店满69减33
- 有效期至: 2025-01-05
- 立即领取
-
- 戴·可·思官方旗舰店满196减27
- 有效期至: 2025-04-01
- 立即领取
-
- 佳婴旗舰店满30减3
- 有效期至: 2025-01-10
- 立即领取
-
- ROTHSCROOSTER旗舰店满19减8
- 有效期至: 2025-01-25
- 立即领取
-
- 荣业官方旗舰店满20减10
- 有效期至: 2025-01-04
- 立即领取
-
- 戴·可·思(Dexter)母婴京东自营旗舰店满48减10
- 有效期至: 2025-01-12
- 立即领取
-
- KOKOROCARE旗舰店满158减100
- 有效期至: 2025-03-28
- 立即领取
-
- RODEL官方旗舰店满59减30
- 有效期至: 2025-01-02
- 立即领取